모델 학습은 데이터 분석, 전처리, 학습, 평가, 등록까지 여러 단계를 순서대로 거친다. 이 단계를 매번 스크립트로 수동 실행하면 실패 지점을 놓치기 쉽고, 재시도나 조건 분기 같은 로직을 직접 코드로 만들어야 한다. Airflow는 이런 단계를 DAG(방향성 비순환 그래프)로 정의하고, 각 단계의 성공/실패/재시도를 스케줄러가 대신 관리해주는 오케스트레이션 도구다. 특히 유용한 건 이 모든 상태를 대시보드를 통해서 확인하고 관리할 수 있다는 점이다. 이런 특성 덕분에 Airflow는 데이터/ML 파이프라인 오케스트레이션 도구 중 가장 널리 쓰인다.
최근에는 더 가벼운 Prefect·Dagster로 옮겨가는 신규 팀도 늘고 있지만1, Airflow가 여전히 가장 널리 쓰이는 건 압도적인 채택 규모와 클라우드 벤더 표준화(Cloud Composer, MWAA) 때문이다2. 모델 학습 파이프라인에 쓰인 사례도 있다. 송금 서비스 Wise는 TensorFlow·PyTorch·XGBoost·H2O·scikit-learn 등 다양한 프레임워크로 학습한 모델을 Amazon SageMaker에서 재학습시키는 과정을 Airflow로 오케스트레이션한다3. 다만 Kubeflow처럼 실험 추적·모델 서빙까지 통합 제공하는 ML 전용 플랫폼은 아니다. 대신 Kubeflow만큼 무거운 인프라가 필요 없는 환경에서는 범용 오케스트레이터(Airflow)가 순서·재시도를, MLflow가 실험 추적·모델 레지스트리를 나눠 맡는 조합이 더 선호된다4.
이 글은 Airflow를 처음 접하는 사람을 대상으로, Kubernetes 클러스터 위에 Helm으로 Airflow를 설치하고 간단한 모의 학습 파이프라인 DAG를 실제로 등록해서 실행해보는 과정을 다룬다. 2편에서는 여기서 만든 구조를 그대로 확장해 실제 LoRA 파인튜닝을 수행하고 MLflow에 모델을 등록하는 과정을 다룬다.
목차
1. 개요
Airflow가 하는 일은 단순하다. “어떤 순서로, 무엇을 실행할지"를 코드(DAG)로 정의해두면, 스케줄러가 그 순서를 지키며 태스크를 실행하고 상태를 추적한다. cron과 다른 점은 태스크 사이의 의존성, 실패 시 재시도, 조건 분기, 실행 이력 조회가 전부 프레임워크 차원에서 제공된다는 것이다.
[분석] → [전처리] → [학습] → [평가] → [등록]
이 글에서는 위 5단계 파이프라인에 품질 게이트(분기)·하이퍼파라미터 병렬 탐색·승격 게이트까지 얹은 구조를 Kubernetes 위에서 실제로 동작시키는 것을 목표로 한다. 각 단계는 실제 학습 로직 대신 로그만 출력하는 스켈레톤(mock) 코드로 구성해서, 인프라 설치와 파이프라인의 제어 흐름 자체에 먼저 집중한다.
2. 핵심 개념 세 가지 — DAG, Task, Operator
Airflow를 설치하기 전에 최소한의 용어부터 정리한다. 아래 세 가지만 이해하면 이후 내용을 따라가는 데 무리가 없다.
| 개념 | 의미 | 이 파이프라인에서의 예 |
|---|---|---|
| DAG | 태스크들의 실행 순서와 의존관계를 정의한 전체 그래프 | lora_pipeline_mock |
| Task | DAG를 구성하는 개별 실행 단위 | analysis, train, register 등 |
| Operator | Task가 실제로 무엇을 실행할지 정의하는 템플릿 | KubernetesPodOperator |
이 중 가장 중요한 것은 Operator다. Operator에 따라 Task 하나가 Bash 명령을 실행할 수도, Python 함수를 호출할 수도, Kubernetes Pod를 띄울 수도 있다. ML 파이프라인에서는 단계별로 필요한 라이브러리와 리소스(CPU/메모리/GPU)가 서로 다른 경우가 많기 때문에, 각 Task를 독립된 컨테이너로 격리해서 실행하는 KubernetesPodOperator를 주로 사용한다.
3. Kubernetes에 Airflow 설치하기
이 섹션에서는 Helm으로 Airflow를 설치하는 과정을 다룬다. 특정 클러스터 구축 도구에 종속된 내용은 다루지 않으며, kubectl과 helm으로 접근 가능한 Kubernetes 클러스터가 이미 준비되어 있다고 가정한다.
3-1. 사전 준비
필요한 것은 세 가지뿐이다.
kubectl,helm이 클러스터에 접근 가능하도록 설정되어 있을 것- Airflow 컴포넌트를 배치할 네임스페이스
- DAG 파일과 로그를 저장할
ReadWriteMany를 지원하는 StorageClass (NFS 계열이면 충분하다)
kubectl create namespace airflow
helm repo add apache-airflow https://airflow.apache.org
helm repo update
3-2. Executor 선택
Airflow는 Task를 어디서, 어떻게 실행할지를 Executor가 결정한다. 대표적으로 두 가지를 비교하면 다음과 같다.
| Executor | 특징 | 적합한 상황 |
|---|---|---|
| CeleryExecutor | Redis + 상시 대기 중인 Worker Pod 필요 | Task가 잦고 처리량이 중요한 운영 환경 |
| KubernetesExecutor | Task마다 별도 Pod를 즉시 생성/삭제, 상시 Worker 불필요 | 자원이 제한적이거나 Task 실행 빈도가 낮은 환경 |
이번 글은 학습 목적의 소규모 테스트이므로 상시 리소스를 점유하지 않는 KubernetesExecutor를 사용한다.
3-3. values.yaml 핵심 옵션
Helm 차트의 기본값 중 이 테스트에서 실제로 의미가 있는 옵션만 정리하면 다음과 같다.
executor: "KubernetesExecutor"

dags:
  persistence:
    enabled: true
    storageClassName: <RWX를 지원하는 StorageClass>
    accessMode: ReadWriteMany
    size: 1Gi

logs:
  persistence:
    enabled: true
    storageClassName: <RWX를 지원하는 StorageClass>
    size: 2Gi

redis:
  enabled: false
flower:
  enabled: false

config:
  kubernetes_executor:
    namespace: airflow
    delete_worker_pods: "True"
redis와 flower는 CeleryExecutor 전용 컴포넌트이므로 KubernetesExecutor에서는 꺼도 된다. dags.persistence는 DAG 파일을 저장할 공간이고, 여러 컴포넌트가 동시에 읽어야 하므로 반드시 ReadWriteMany 모드가 필요하다.
3-4. 설치 및 확인
helm install airflow apache-airflow/airflow \
  -n airflow -f values.yaml --timeout 5m
공식 Helm 차트가 제공하는 값 목록은 방대하지만, 이 테스트에서 실제로 건드린 건 위 values.yaml 옵션뿐이다.
설치가 끝나면 아래 컴포넌트가 모두 Running 상태인지 확인한다.
$ kubectl -n airflow get pods

NAME                                     READY   STATUS    RESTARTS   AGE
airflow-api-server-7bb8f87656-2frrc      1/1     Running   0          22h
airflow-dag-processor-6c9d8b74f7-kgnsn   2/2     Running   0          22h
airflow-postgresql-0                     1/1     Running   0          22h
airflow-scheduler-595d44585d-kwb5q       2/2     Running   0          22h
airflow-triggerer-0                      2/2     Running   0          22h
4. 학습 파이프라인 DAG 작성
4-1. 왜 Airflow로 구성하는가
이 파이프라인은 세 가지를 요구한다: 데이터 품질이 기준에 못 미치면 학습 자체를 건너뛰는 분기, 여러 하이퍼파라미터 후보를 동시에 시도하는 병렬 실행, 새 모델이 기존보다 나을 때만 등록하는 승격 게이트. 이 세 가지를 cron이나 셸 스크립트로 직접 짜려면 상태 추적·재시도·조건 분기·실행 이력 조회를 전부 손으로 구현해야 한다. Airflow는 이걸 각각 BranchPythonOperator, .expand(), ShortCircuitOperator 몇 줄로 제공하고, 실행 상태는 대시보드에 자동으로 노출된다.
각 단계를 실행하는 데는 KubernetesPodOperator를 쓴다. 단계마다 컨테이너를 분리하면 다음 이점이 생긴다.
- 단계마다 다른 이미지(학습용 GPU 이미지, 평가용 경량 이미지 등)를 쓸 수 있다
- 단계별로 CPU/메모리/GPU 요청량을 독립적으로 지정할 수 있다
- 한 단계의 의존성 문제가 다른 단계의 실행 환경에 영향을 주지 않는다
4-2. 파이프라인 구조
analysis → preprocess → validate_dataset → decide_after_validation
                                                  ├─(불합격)→ skip_training (종료)
                                                  └─(합격)  → train[rank=8/16/32] (병렬 하이퍼파라미터 스윕)
                                                                    └─→ evaluate (baseline과 비교)
                                                                             └─→ check_promotion
                                                                                    ├─(baseline보다 우수)→ register
                                                                                    └─(baseline 이하)     → (종료)
| Task ID | 역할 | 담당 Airflow 기능 |
|---|---|---|
analysis | 데이터 통계(샘플 수, null/중복 비율 등) 산출 | — |
preprocess | 토큰화·정규화로 학습 가능한 포맷 변환 | — |
validate_dataset | 데이터 품질을 검증하고 결과를 XCom으로 반환 | do_xcom_push |
decide_after_validation | 검증 결과를 읽어 train 또는 skip_training으로 분기 | BranchPythonOperator |
skip_training | 품질 미달 시 로그만 남기고 종료 | — |
train | 하이퍼파라미터 후보(rank 8/16/32)별 병렬 학습 | .expand() |
evaluate | 학습 결과를 baseline과 비교해 결과를 XCom으로 반환 | do_xcom_push |
check_promotion | baseline 대비 우수한지 판독, 미달 시 이후 스킵 | ShortCircuitOperator |
register | baseline보다 우수한 모델만 레지스트리에 등록 | — |
실제 학습 로직과 모델 등록은 다음 편에서 다룬다. 이번 편에서는 각 Task가 로그만 남기는 자리표시자로 구성하되, 분기·병렬·게이트라는 제어 흐름 자체는 실제로 동작하는 상태로 만든다.
4-3. 구성 요소별로 보기
전체 코드를 한 번에 보기 전에, 새로 등장하는 요소를 하나씩 짚는다.
공통 Pod 실행 템플릿
analysis·preprocess·validate_dataset·skip_training·evaluate·register는 모두 KubernetesPodOperator를 직접 쓰고 같은 옵션(get_logs, is_delete_operator_pod, do_xcom_push)을 반복하므로, 헬퍼 함수로 뽑아낸다. (train은 .expand()로 별도 구성하고, decide_after_validation·check_promotion은 Pod가 아닌 Python 콜러블이라 이 헬퍼를 쓰지 않는다.)
def _pod_task(task_id: str, script: str) -> KubernetesPodOperator:
    return KubernetesPodOperator(
        task_id=task_id,
        namespace=NAMESPACE,
        image=IMAGE,
        cmds=["python", "-c"],
        arguments=[script],
        name=f"lora-mock-{task_id}".replace("_", "-"),
        on_finish_action="delete_pod",
        get_logs=True,
        is_delete_operator_pod=True,
        do_xcom_push=True,
    )
do_xcom_push=True를 켜면, 컨테이너 안에서 /airflow/xcom/return.json에 JSON을 쓰는 것만으로 그 값이 Airflow XCom으로 자동 수집된다. 별도의 API 호출 없이 Pod 안 스크립트가 결과를 다음 Task에 넘기는 방법이다.
XCom으로 데이터를 주고받는 방식과 그 한계
return.json의 값은 Pod 종료 시 KubernetesPodOperator가 읽어 Airflow 메타데이터 DB(PostgreSQL)에 저장하고, 다음 Task는 xcom_pull()로 그 DB를 조회한다. 오케스트레이션 메타데이터용 DB이다 보니 백엔드별로 사실상의 크기 제한이 있다(MySQL 기준 약 64KB)5.
그래서 실무 컨벤션은 XCom에 플래그·ID·경로 같은 작은 제어값만 태우고, 실제 대용량 데이터(체크포인트, 데이터셋 등)는 S3/MinIO에 쓴 뒤 그 경로만 XCom으로 넘기는 것이다. Airflow도 이 패턴을 apache-airflow-providers-common-io의 Object Storage XCom Backend로 공식화해, 임계값 이상 값은 자동으로 오브젝트 스토리지에 오프로드한다.
이 파이프라인은 {"passed": true, "accuracy": 0.88} 같은 몇 바이트짜리 플래그만 주고받아 지금 방식으로 충분하다. 다음 편에서 실제 체크포인트를 넘길 때는 MinIO+포인터 방식으로 바뀐다.
순차 연결 — >> 연산자
Task를 만들었다고 순서가 정해지는 건 아니다. 의존관계는 >>로 별도 선언해야 한다.
analysis >> preprocess >> validate_dataset
품질 게이트 — BranchPythonOperator
validate_dataset이 XCom으로 남긴 passed 값을 읽어, 다음에 실행할 Task의 task_id를 리턴한다. 리턴되지 않은 나머지 형제 Task는 자동으로 skipped 처리된다.
def _decide_after_validation(**context):
    result = context["ti"].xcom_pull(task_ids="validate_dataset")
    if isinstance(result, str):
        result = json.loads(result)
    return "train" if result.get("passed") else "skip_training"

decide_after_validation = BranchPythonOperator(
    task_id="decide_after_validation",
    python_callable=_decide_after_validation,
)
하이퍼파라미터 병렬 탐색 — .expand()
rank 후보 개수만큼 train Task를 런타임에 동적으로 늘린다. train이라는 이름은 하나지만, 실제로는 rank별로 별도 Pod가 동시에 뜬다.
train = KubernetesPodOperator.partial(
    task_id="train",
    namespace=NAMESPACE,
    image=IMAGE,
    cmds=["python", "-c"],
    name="lora-mock-train",
    on_finish_action="delete_pod",
    get_logs=True,
    is_delete_operator_pod=True,
).expand(
    arguments=[[f"print('LoRA 학습 (rank={r}) 완료')"] for r in LORA_RANKS]
)
승격 게이트 — ShortCircuitOperator
콜러블이 False를 반환하면 하류 Task 전체가 스킵된다. 별도의 분기 대상을 지정할 필요 없이 “여기서 그냥 멈춘다"를 표현할 때 쓴다.
def _check_promotion(**context):
    result = context["ti"].xcom_pull(task_ids="evaluate")
    if isinstance(result, str):
        result = json.loads(result)
    return result.get("passed") is True

check_promotion = ShortCircuitOperator(
    task_id="check_promotion",
    python_callable=_check_promotion,
)
4-4. 전체 코드
import datetime
import json

from airflow import DAG
from airflow.operators.python import BranchPythonOperator, ShortCircuitOperator
from airflow.providers.cncf.kubernetes.operators.pod import KubernetesPodOperator

IMAGE = "python:3.12-slim-bookworm"
NAMESPACE = "airflow"
LORA_RANKS = [8, 16, 32]

default_args = {
    "owner": "mlops_engineer",
    "start_date": datetime.datetime(2026, 1, 1),
    "retries": 0,
}


def _pod_task(task_id: str, script: str) -> KubernetesPodOperator:
    return KubernetesPodOperator(
        task_id=task_id,
        namespace=NAMESPACE,
        image=IMAGE,
        cmds=["python", "-c"],
        arguments=[script],
        name=f"lora-mock-{task_id}".replace("_", "-"),
        on_finish_action="delete_pod",
        get_logs=True,
        is_delete_operator_pod=True,
        do_xcom_push=True,
    )


def _decide_after_validation(**context):
    result = context["ti"].xcom_pull(task_ids="validate_dataset")
    if isinstance(result, str):
        result = json.loads(result)
    return "train" if result.get("passed") else "skip_training"


def _check_promotion(**context):
    result = context["ti"].xcom_pull(task_ids="evaluate")
    if isinstance(result, str):
        result = json.loads(result)
    return result.get("passed") is True


with DAG(
    dag_id="lora_pipeline_mock",
    default_args=default_args,
    schedule=None,
    catchup=False,
    tags=["llm", "lora", "mock"],
) as dag:

    analysis = _pod_task("analysis", "print('1. 데이터셋 분석 완료')")

    preprocess = _pod_task("preprocess", "print('2. 전처리/토큰화 완료')")

    validate_dataset = _pod_task(
        "validate_dataset",
        "import json, pathlib; "
        "print('3. 데이터 품질 검증 - PASS'); "
        "p = pathlib.Path('/airflow/xcom/return.json'); "
        "p.parent.mkdir(parents=True, exist_ok=True); "
        "p.write_text(json.dumps({'passed': True}))",
    )

    decide_after_validation = BranchPythonOperator(
        task_id="decide_after_validation",
        python_callable=_decide_after_validation,
    )

    skip_training = _pod_task(
        "skip_training", "print('데이터 품질 미달 - 학습을 건너뜁니다')"
    )

    train = KubernetesPodOperator.partial(
        task_id="train",
        namespace=NAMESPACE,
        image=IMAGE,
        cmds=["python", "-c"],
        name="lora-mock-train",
        on_finish_action="delete_pod",
        get_logs=True,
        is_delete_operator_pod=True,
    ).expand(
        arguments=[[f"print('4. LoRA 학습 (rank={r}) 완료')"] for r in LORA_RANKS]
    )

    evaluate = _pod_task(
        "evaluate",
        "import json, pathlib; "
        "print('5. 평가 완료 - accuracy=0.88, baseline=0.85 대비 우수'); "
        "p = pathlib.Path('/airflow/xcom/return.json'); "
        "p.parent.mkdir(parents=True, exist_ok=True); "
        "p.write_text(json.dumps({'passed': True, 'accuracy': 0.88}))",
    )

    check_promotion = ShortCircuitOperator(
        task_id="check_promotion",
        python_callable=_check_promotion,
    )

    register = _pod_task(
        "register", "print('6. 모델 등록 완료 - llm-lora-mock:v1.0.0')"
    )

    analysis >> preprocess >> validate_dataset >> decide_after_validation
    decide_after_validation >> [train, skip_training]
    train >> evaluate >> check_promotion >> register
4-5. DAG 레벨 설정
4-3에서 다루지 않은 나머지는 with DAG(...)에 넘긴 DAG 전체 설정이다.
| 설정 | 의미 |
|---|---|
default_args["start_date"] | 이 DAG가 스케줄상 존재할 수 있는 시작 시점 |
default_args["retries"] | Task 실패 시 자동 재시도 횟수. 0이라 지금은 한 번 실패하면 바로 DAG Run이 실패로 끝난다 |
schedule=None | 주기 스케줄이 없다는 뜻. airflow dags trigger나 UI의 Trigger 버튼으로 수동 실행했을 때만 DAG Run이 생긴다 |
catchup=False | start_date 이후 실행되지 않은 과거 스케줄 구간을 한꺼번에 소급 실행(backfill)하지 않는다 |
retries: 0은 이번 스켈레톤 단계에서 실패를 감추지 않고 바로 드러내기 위한 의도적인 설정이다. 다음 편에서 실제 학습 로직으로 바뀌면 이미지 pull 실패 같은 일시적 오류에 대비해 이 값을 늘리게 된다.
5. DAG 배포 및 실행
DAG 코드가 준비되면 이를 Airflow가 인식하는 위치에 배치하고, UI에서 파싱 여부와 실행 결과를 확인하는 순서로 진행한다.
5-1. DAG 파일 배치와 반영 확인
Helm 차트로 설치한 Airflow는 dags.persistence로 만든 PVC를 DAG 저장소로 사용하는데, Airflow 3.x부터 이 PVC를 실제로 마운트하는 컴포넌트는 scheduler가 아니라 DAG 파싱을 전담하는 dag-processor다. 운영 환경에서는 보통 git-sync로 저장소를 자동 동기화하지만, 이번처럼 단발성 테스트에서는 dag-processor Pod에 파일을 직접 복사하면 된다.
kubectl -n airflow cp dag_lora_mock.py \
  $(kubectl -n airflow get pod -l component=dag-processor -o jsonpath='{.items[0].metadata.name}'):/opt/airflow/dags/dag_lora_mock.py
dag-processor는 기본 300초 주기로 DAG 폴더를 스캔하므로, 처음 복사하거나 이후 파일을 수정해도 최대 300초 안에 자동 반영된다. 이후로는 Airflow UI의 DAG 상세 화면에서 전체를 재트리거하거나, 일부 Task만 실패했다면 그 Task부터 Clear해서 이미 성공한 단계는 건너뛰고 재시작할 수 있다.
300초를 기다리지 않고 즉시 반영 여부를 확인하고 싶다면 airflow dags reserialize CLI 명령으로 DagBag 폴더 전체를 강제로 다시 스캔시키면 된다. 이 명령은 메타데이터 DB에 저장된 직렬화 DAG를 다시 생성할 뿐, 실행까지 시키지는 않는다.
kubectl -n airflow exec deploy/airflow-scheduler -- airflow dags reserialize
5-2. UI 확인 및 실행
Airflow API 서버에 접속해 DAG가 파싱 오류 없이 목록에 나타나는지 먼저 확인한다.
kubectl -n airflow port-forward svc/airflow-api-server 8080:8080
브라우저에서 http://localhost:8080에 접속하면 DAGs 목록 화면이 뜨고, 방금 배포한 lora_pipeline_mock이 파싱 오류 없이 아래처럼 보여야 한다.
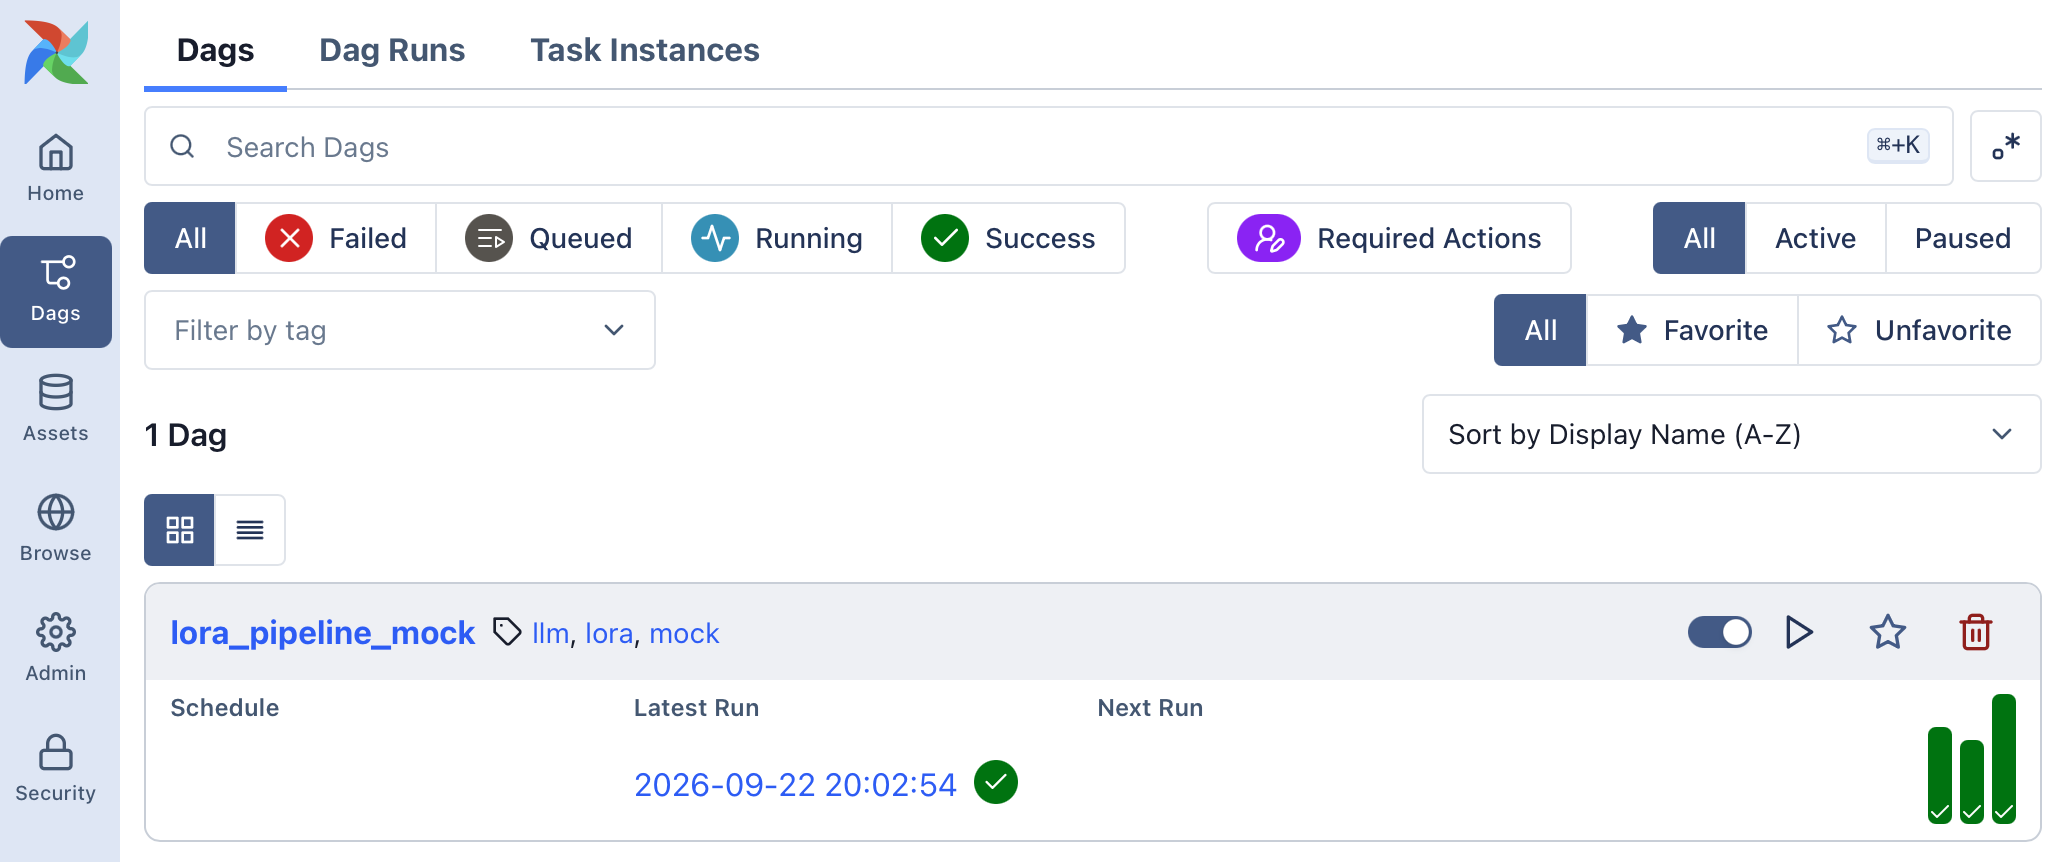
이 dag_id가 메타데이터 DB에 처음 등록되는 순간에는 기본적으로 pause 상태라 스케줄이 있어도 자동 실행되지 않는다(dags_are_paused_at_creation=True). DAG 이름 옆의 토글을 켜서 unpause 상태로 바꾼 뒤, 우측 상단의 Trigger(▷) 버튼을 누르면 그 자리에서 바로 실행된다. 이 pause 여부는 DAG 파일이 아니라 DB에 저장되는 값이라, 이후 같은 dag_id로 재배포해도 한 번 unpause한 상태는 그대로 유지된다 — 다음부터는 Trigger 버튼만 누르면 된다.
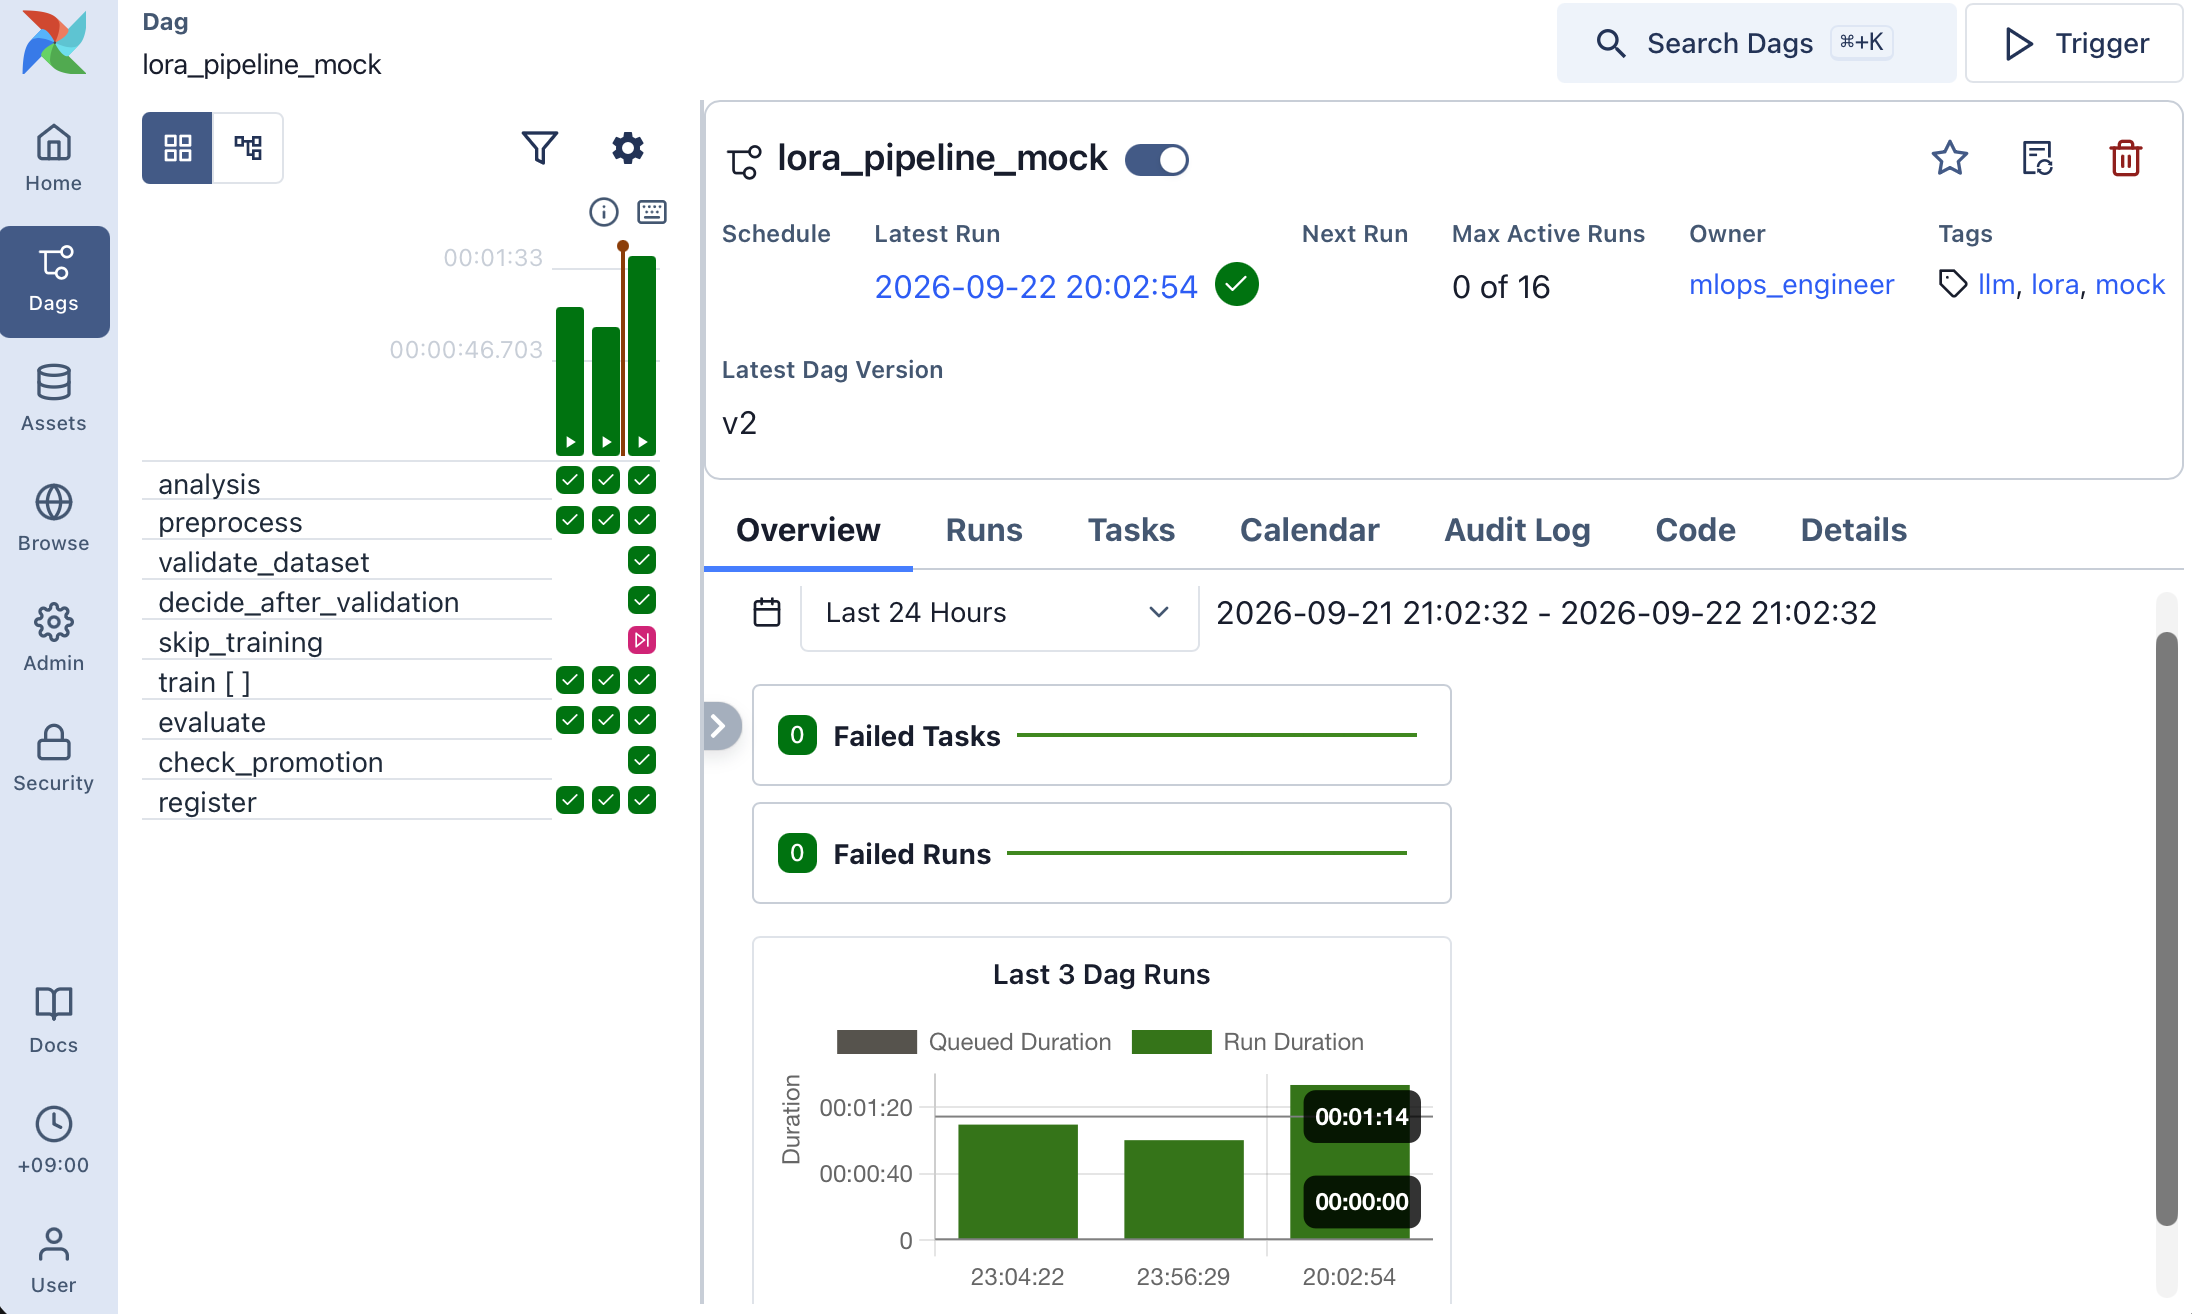
Task 카드가 모두 초록색(또는 분기로 스킵된 Task는 회색)으로 바뀌고 Failed Tasks가 0으로 표시되면 파이프라인이 의도한 대로 동작한 것이다. 실제로 위 DAG를 트리거해서 얻은 결과는 다음과 같다.
$ airflow tasks states-for-dag-run lora_pipeline_mock manual__2026-09-22T11:02:54.282079+00:00

dag_id             | task_id                 | state   | start_date  | end_date    | map_index
===================+=========================+=========+=============+=============+==========
lora_pipeline_mock | analysis                | success | 11:02:58    | 11:03:12    |
lora_pipeline_mock | preprocess              | success | 11:03:15    | 11:03:23    |
lora_pipeline_mock | validate_dataset        | success | 11:03:27    | 11:03:35    |
lora_pipeline_mock | decide_after_validation | success | 11:03:39    | 11:03:42    |
lora_pipeline_mock | skip_training           | skipped | 11:03:42    | 11:03:42    |
lora_pipeline_mock | train                   | success | 11:03:46    | 11:03:57    | 0
lora_pipeline_mock | train                   | success | 11:03:46    | 11:03:57    | 1
lora_pipeline_mock | train                   | success | 11:03:47    | 11:03:57    | 2
lora_pipeline_mock | evaluate                | success | 11:04:01    | 11:04:10    |
lora_pipeline_mock | check_promotion         | success | 11:04:13    | 11:04:16    |
lora_pipeline_mock | register                | success | 11:04:19    | 11:04:28    |
핵심만 짚으면: 분기는 skip_training을 정확히 skipped 처리했고, train 세 개(map_index 0/1/2)는 시작 시각이 11:03:46~47로 거의 동일해 진짜 병렬로 떴다. 트리거(11:02:54)부터 register 종료(11:04:28)까지 약 94초, 종료 후 kubectl -n airflow get pods에도 Task Pod는 남지 않았다.
이번 실행은 validate_dataset/evaluate가 항상 passed: true를 반환하는 “정상 경로"만 검증한 것이다. skip_training 분기와 check_promotion의 조기 종료 자체는 코드상 존재하지만, 실패 경로(passed: false)는 이번 실행에서 실제로 타지 않았다는 점은 짚어둔다.
5-3. 워커 Pod와 작업 Pod 이중 구조
실행 도중 kubectl -n airflow get pods를 찍어보면 Task 하나당 이름이 다른 Pod가 동시에 두 개씩 떠 있는 게 보인다. 아래는 validate_dataset 실행 중 실제로 캡처한 스냅샷이다.
NAME                                            READY   STATUS              RESTARTS   AGE
lora-mock-validate-dataset-6fojrk8x             0/2     ContainerCreating   0          0s
lora-pipeline-mock-validate-dataset-8axojmnp    1/1     Running             0          6s
Pod가 둘인 이유는 KubernetesExecutor와 KubernetesPodOperator가 서로 다른 층위에서 각자 Pod를 만들기 때문이다. Executor가 띄운 워커 Pod(lora-pipeline-mock-validate-dataset-8axojmnp, Airflow 이미지, 격리·재시도·로그 수집 담당)가 airflow tasks run을 실행하다가, 그 안에서 Kubernetes API를 다시 호출해 Operator가 지정한 사용자 이미지로 작업 Pod(lora-mock-validate-dataset-6fojrk8x)를 띄우고 완료를 기다린다.
scheduler
  │ Task 배정
  ▼
[워커 Pod]  lora-pipeline-mock-validate-dataset-...   ← KubernetesExecutor가 생성
  airflow tasks run 실행 / 상태·재시도·로그 관리
  │ execute() 안에서 Kubernetes API 재호출
  ▼
[작업 Pod]  lora-mock-validate-dataset-...            ← KubernetesPodOperator가 생성
  실제 image/cmds 실행 (지금은 print, 다음 편부터 학습 스크립트)
Executor·Operator 조합을 바꾸면 이 구조가 달라지고, 어느 쪽이 맞는지는 “Task마다 격리된 커스텀 이미지가 필요한가"로 갈린다.
| 조합 | Pod 개수 | 적합한 상황 |
|---|---|---|
| KubernetesExecutor + KubernetesPodOperator (이 글) | 2개 (워커 + 작업) | Task마다 다른 이미지·리소스가 필요할 때 (예: 이 글처럼 train만 GPU 이미지) |
| CeleryExecutor + KubernetesPodOperator | 1개 (상시 Celery Worker 프로세스 안에서 작업 Pod만 생성) | Task 실행 빈도가 높아 Pod를 매번 새로 띄우는 오버헤드를 줄이고 싶을 때 |
| KubernetesExecutor + PythonOperator | 1개 (워커 Pod 안에서 Python 함수를 직접 실행, 작업 Pod 없음) | 모든 Task가 Airflow 워커와 같은 의존성으로 충분한, 가벼운 로직만 있을 때 |
여기서는 KubernetesExecutor + KubernetesPodOperator 조합을 사용했는데, Pod 개수만 보면 Celery 조합이 매 실행마다 더 적게 쓴다 — Celery Worker는 이미 떠 있는 프로세스라 작업 Pod 하나만 추가로 띄우면 되지만, KubernetesExecutor는 Task마다 워커 Pod를 새로 부팅한 뒤 그 안에서 작업 Pod를 또 띄운다. 다만 Celery는 그 “이미 떠 있는 프로세스"를 Task가 없을 때도 상시 유지해야 하고, 이 파이프라인처럼 실행 빈도가 낮은 배치 작업에서는 그 상시 대기 비용이 매 실행의 2-Pod 오버헤드보다 크다. KubernetesExecutor는 실행 중이 아닐 때 워커·작업 Pod가 아예 없어 idle 비용이 0이므로, “Task가 잦으면 Celery, 드문 배치면 KubernetesExecutor"라는 트레이드오프에서 이 글은 후자를 택했다.
6. 마치며
여기까지 Kubernetes 위에 Airflow를 Helm으로 설치하고, LoRA 학습과 모델 등록을 위한 모의 파이프라인을 Airflow에서 직접 구성해봤다. 품질 게이트(validate_dataset → 분기) · 하이퍼파라미터 병렬 탐색(train.expand()) · 승격 게이트(check_promotion)까지 포함한 이 파이프라인을 KubernetesPodOperator 기반으로 정의해 처음부터 끝까지 성공적으로 실행했다. 아직은 각 단계가 로그만 출력하는 뼈대 수준이지만, 분기·병렬·게이트라는 제어 흐름 자체는 실제로 동작하는 상태로 검증했다. 실제 학습 로직과 모델 레지스트리 등록은 다음 편에서 다룬다.
참고문헌
Orchestra, Dagster vs Airflow — Dagster의 asset 기반 계보 추적이 오픈소스에서 기본 제공되는 반면 Airflow는 별도 OpenLineage 프로바이더나 외부 카탈로그가 필요하다는 비교, 그리고 Apache Airflow 2가 2026년 4월 22일 EOL을 맞아 마이그레이션을 촉발하는 배경. ↩︎
pracdata.io, State of Open Source Workflow Orchestration Systems 2025 — Airflow가 2024년 3억 2천만 다운로드로 2위 도구의 10배를 기록했다는 통계; Google Cloud, Cloud Composer 개요 및 AWS, Amazon MWAA — 두 클라우드 벤더가 관리형 워크플로우 서비스의 기반으로 Airflow를 채택한 사례. ↩︎
Astronomer, Airflow at Wise: Data Orchestrator in Machine Learning — Wise가 TensorFlow·PyTorch·XGBoost·H2O·scikit-learn으로 학습한 모델을 Amazon SageMaker에서 재학습시키는 과정을 Airflow로 오케스트레이션하는 실제 사례. ↩︎
Astronomer, Best practices for orchestrating MLOps pipelines with Airflow — Airflow가 담당하는 오케스트레이션 영역과 MLflow 등 실험 추적/레지스트리 도구와의 역할 분리에 대한 가이드. ↩︎
Astronomer, Pass data between tasks — XCom이 Airflow 메타데이터 DB에 저장되며, 백엔드별로 크기 제한(Postgres 1GB, SQLite 2GB, MySQL 64KB)이 있다는 설명. ↩︎