3편에서는 문서 검색 API와 MCP 서버를 다루었다. 이번 편에서는 챗봇과 모델 서버 사이에서 요청을 중개하는 LiteLLM의 구성을 설명한다. LiteLLM 설정에서 핵심이 되는 사항은 두 가지다. 하나는 처리할 수 있는 요청의 범위를 정하는 컨텍스트 한도이고, 다른 하나는 로컬 모델이 요청을 처리하지 못할 때의 대응 방식인 fallback이다. 특히 fallback은 문서와 대화를 외부로 내보내지 않는다는 프로젝트의 전제와 충돌할 수 있으므로, 설계 시 프라이버시를 함께 고려해야 한다. 아울러 요청에 사용자 식별 헤더를 붙여 사용량을 사용자별로 나눠 보는 방법도 다룬다.
이 글은 GitHub 저장소에 포함된 코드를 기준으로 설명한다. 저장소를 아직 클론하지 않았다면 다음과 같이 클론한다. LiteLLM은 vllm-mlx, Postgres와 함께 동작하므로 전체 스택을 띄우는 방법은 1편의 3~4절을 따른다.
git clone https://github.com/cnapcloud/mlx-rag-chatbot.git
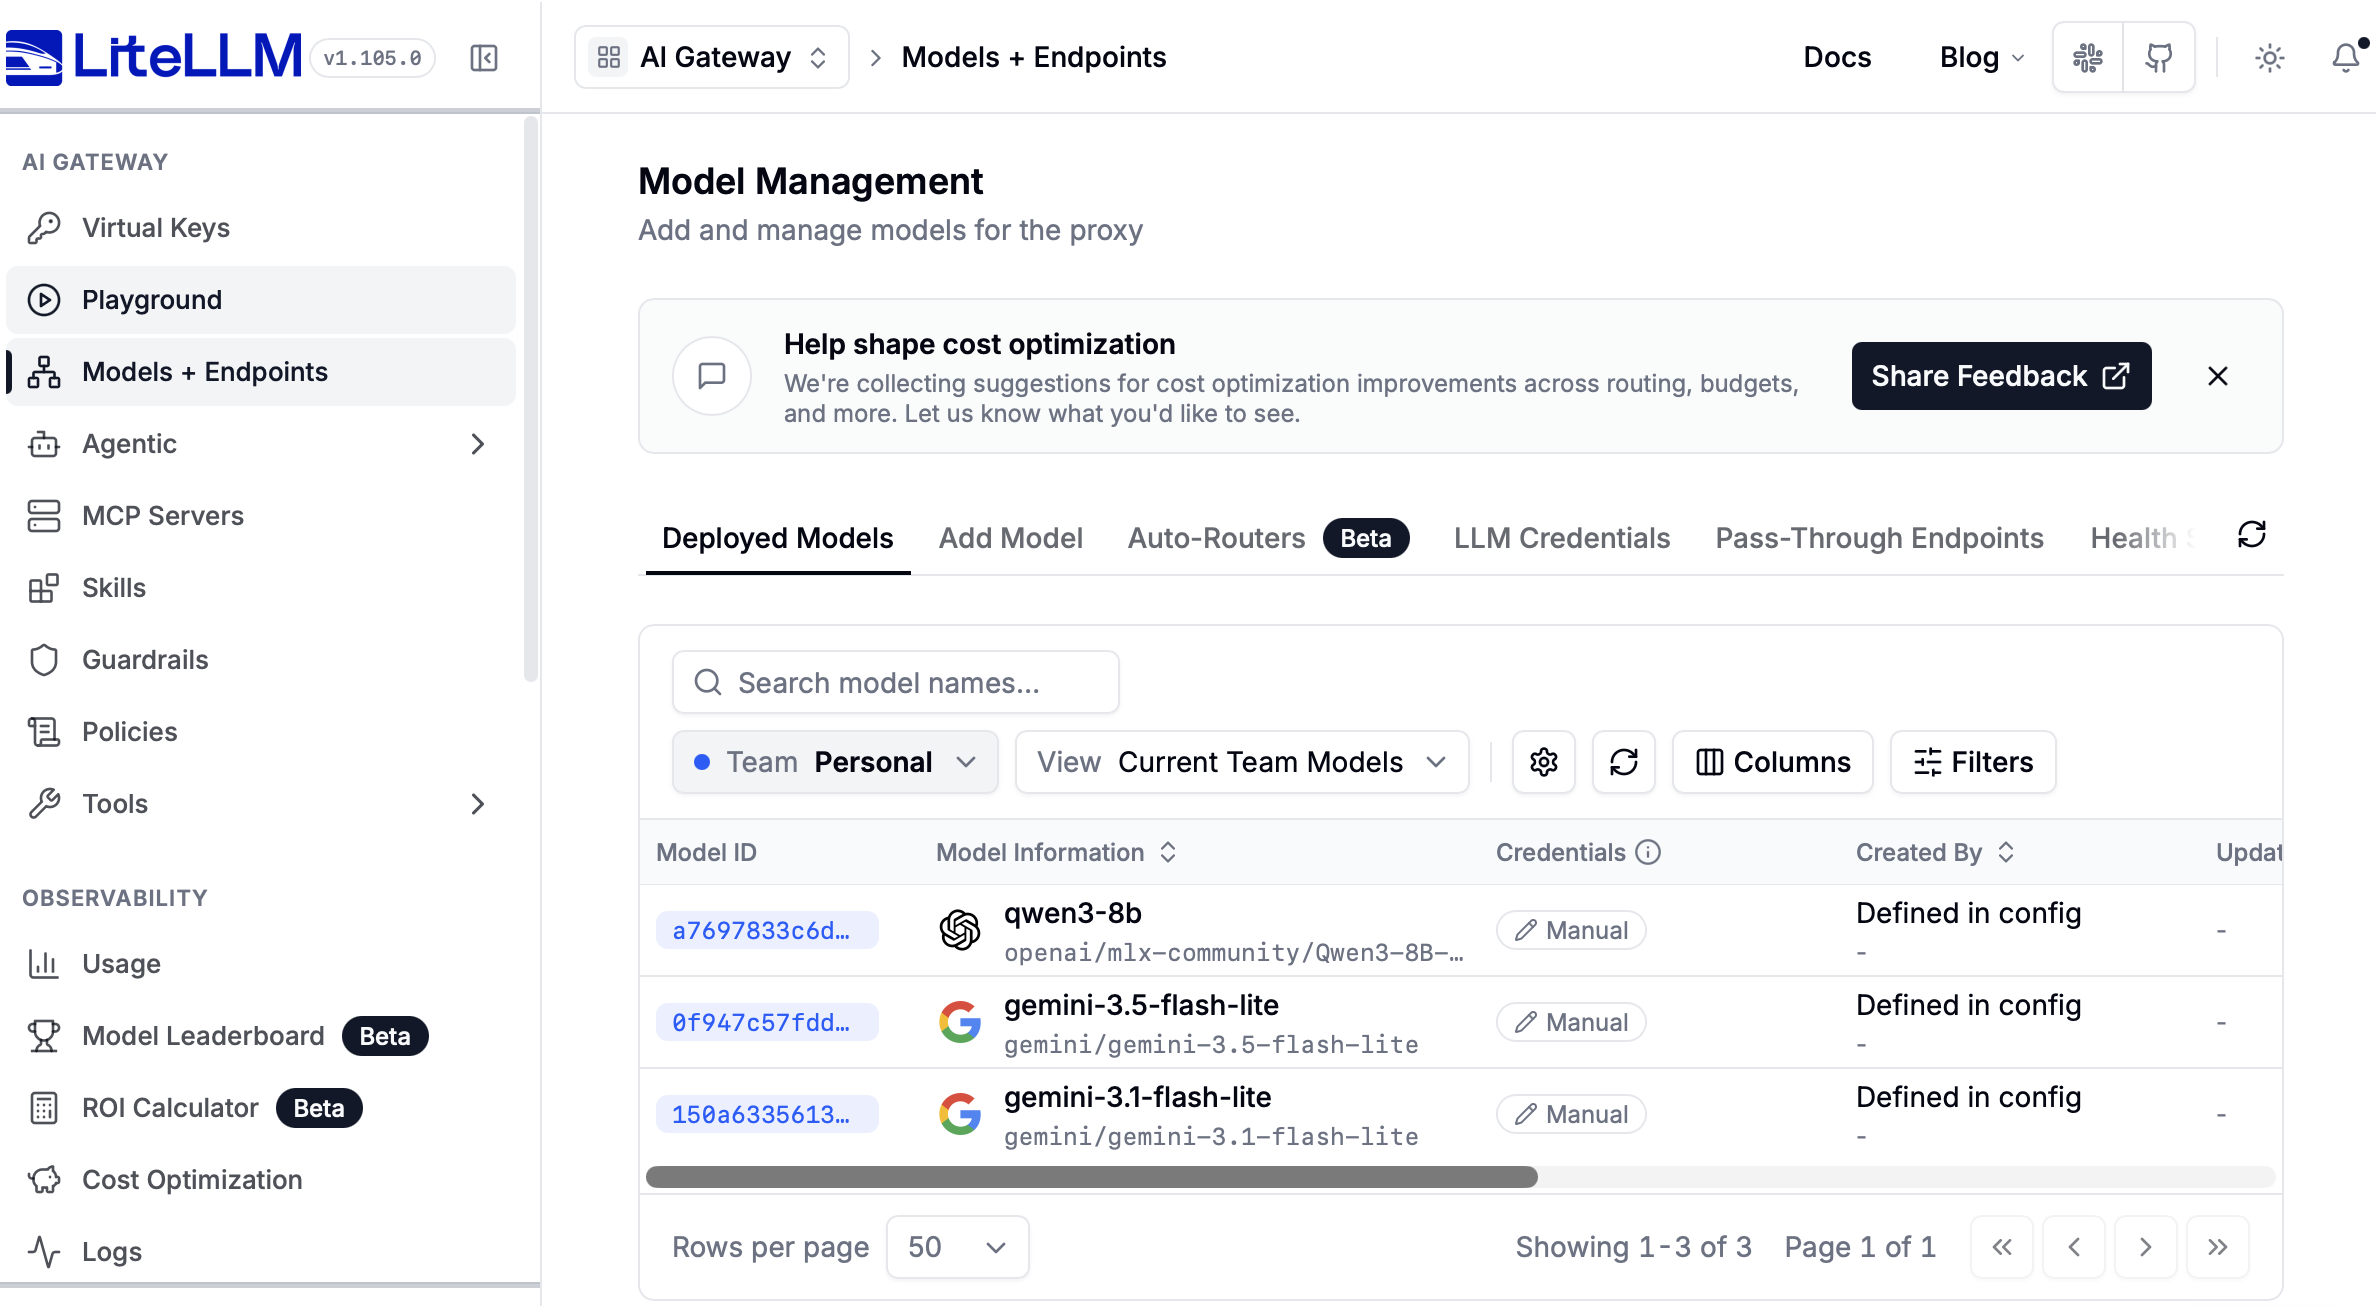
cd mlx-rag-chatbot
1. LiteLLM 소개
LiteLLM은 여러 LLM 제공자를 OpenAI 호환 API 하나로 묶어 주는 프록시(게이트웨이)다. 애플리케이션은 제공자마다 다른 SDK와 요청 형식을 신경 쓰지 않고 LiteLLM 한 곳만 호출하고, 어느 모델로 보낼지는 LiteLLM이 정한다.
- 제공자별 API를 하나의 OpenAI 호환 형식으로 통일
- 여러 배포에 대한 라우팅과 로드 밸런싱
- 실패 시 재시도와 다른 모델로의 fallback
- 가상 키 발급을 통한 접근 통제와 키별 예산 및 속도 제한
- 키, 사용자, 모델별 사용량과 비용의 집계
- 로깅 도구 연동과 입출력 검사용 가드레일
이 프로젝트에서 LiteLLM은 LibreChat과 모델 서버 사이의 단일 창구 역할을 한다. LibreChat은 LiteLLM 하나만 호출하고, LiteLLM이 요청을 로컬 모델(vllm-mlx)이나 Gemini로 전달한다. 로컬 모델이 응답하지 못하면 Gemini로 넘기는 fallback을 두고, 모델 서버가 막아 주지 않는 입력 길이 한도도 앞단에서 점검한다. 요청에 붙는 사용자 식별 헤더로는 Admin UI에서 사용량을 사용자별로 확인한다.
2. 시작하기
LiteLLM은 compose.yaml의 litellm 서비스로 실행된다. 전체 스택은 1편의 docker compose up -d --build로 함께 올라가고, LiteLLM만 따로 올릴 때는 다음과 같이 한다. .env에 LITELLM_MASTER_KEY와 GEMINI_API_KEY가 있어야 하고, Postgres는 depends_on으로 함께 시작된다.
docker compose up -d litellm        # LiteLLM 시작 (postgres 포함)
docker compose logs -f litellm      # 시작 로그와 요청 로그 확인
curl http://localhost:4000/health/liveliness
litellm.yaml은 컨테이너에 읽기 전용으로 마운트되고 시작할 때 한 번 읽힌다. 모델이나 fallback 설정을 바꾼 뒤에는 컨테이너를 재시작해야 반영된다.
docker compose restart litellm
단, GEMINI_API_KEY 같은 환경변수는 컨테이너를 만들 때 고정되므로 restart로는 반영되지 않는다. 키를 새로 설정하거나 바꿨다면 docker compose up -d litellm으로 컨테이너를 다시 만든다. 키가 비어 있어도 LiteLLM은 정상 기동하고, fallback이 일어나는 순간에야 “Missing Gemini API key” 오류가 난다.
vllm-mlx는 컨테이너가 아니라 호스트에서 make run(2편)으로 따로 띄운다. LiteLLM이 먼저 올라와도 vllm-mlx가 없으면 qwen3-8b 호출만 실패하고 fallback이 동작한다.
LiteLLM을 거쳐 qwen3-8b가 응답하는지는 다음 curl로 확인한다. 마스터 키는 .env의 LITELLM_MASTER_KEY를 쓴다.
export LITELLM_MASTER_KEY=$(grep ^LITELLM_MASTER_KEY .env | cut -d= -f2)

curl -s http://localhost:4000/v1/chat/completions \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3-8b",
    "messages": [{"role": "user", "content": "한 문장으로 자기소개를 해줘."}],
    "max_tokens": 512
  }' | jq '{model, answer: .choices[0].message.content}'
답변이 나오면 LiteLLM과 vllm-mlx가 모두 정상이다. vllm-mlx를 중지한 채 같은 요청을 보내면 5절의 fallback으로 Gemini의 응답이 돌아온다.
3. 모델 등록
모델은 config/litellm.yaml의 model_list에 등록한다. 아래는 등록에 필요한 항목이며, timeout은 5.2절에서 덧붙인다.
model_list:
  - model_name: qwen3-8b
    litellm_params:
      model: openai/mlx-community/Qwen3-8B-4bit
      api_base: http://host.docker.internal:8100/v1
      api_key: not-needed
    model_info:
      max_input_tokens: 28672 # VLLM_CONTEXT(32768) - VLLM_MAX_TOKENS(4096)

  - model_name: gemini-3.5-flash-lite
    litellm_params:
      model: gemini/gemini-3.5-flash-lite
      api_key: os.environ/GEMINI_API_KEY

  - model_name: gemini-3.1-flash-lite
    litellm_params:
      model: gemini/gemini-3.1-flash-lite
      api_key: os.environ/GEMINI_API_KEY
- OpenAI 호환 API를 제공하는 vllm-mlx의
openai/접두어 등록, 컨테이너에서 호스트로 나가는host.docker.internal:8100주소, 인증이 없어 임의 값을 넣은api_key gemini/접두어로 등록한 Gemini 두 모델, 환경 변수GEMINI_API_KEY에서 읽는 키, 기본 fallback 대상과 그 과부하 시 쓰는 예비 모델의 역할 분담
모델은 이 파일 대신 관리 UI에서도 추가할 수 있다(7절에서 다룬다). 이 시리즈는 재현 가능하도록 파일을 기준으로 한다.
4. 모델 컨텍스트 한도 설계
4.1 입력 한도의 필요성
2편에서 vllm-mlx의 시퀀스당 한도는 --max-kv-size(VLLM_CONTEXT) 32768 토큰을 기준으로 설정했다. 이 옵션은 KV cache 크기를 정할 뿐 입력을 거부하지 않으며, 설계상으로는 한도를 넘으면 오래된 앞쪽 토큰이 밀려나야 한다. 그러나 2편의 이슈에 적었듯 실제로는 37K 입력도 오류 없이 처리되고 앞부분이 유지되어, 서버가 이 한도를 입력에 강제하지 않는다. 그래서 입력이 한도를 넘는지는 서버 앞에서 확인해야 하고, 이 역할을 LiteLLM 게이트웨이가 맡는다.
4.2 출력 토큰 예약
컨텍스트 창은 입력과 출력이 함께 쓴다. 입력이 32768을 꽉 채우면 답변이 들어갈 자리가 없다. vllm-mlx는 max_tokens가 없는 요청에 4096을 기본 생성 상한(VLLM_MAX_TOKENS)으로 쓰므로, 그만큼을 출력용으로 빼 둔다.
컨텍스트 창           32768   VLLM_CONTEXT
출력 예약           −  4096   VLLM_MAX_TOKENS
─────────────────────────────
실제 허용 입력         28672   litellm.yaml 의 max_input_tokens
이 값을 model_info.max_input_tokens에 적고, router_settings에서 enable_pre_call_checks: true를 켠다. 이 점검이 켜져 있으면 LiteLLM이 요청을 보내기 전에 입력 토큰 수를 세어 max_input_tokens를 넘는 모델을 후보에서 제외한다. 후보가 없으면 모델 서버까지 가지 않고 컨텍스트 초과 오류가 돌아온다.
model_list:
  - model_name: qwen3-8b
    # litellm_params 생략 (3절과 동일)
    model_info:
      max_input_tokens: 28672

router_settings:
  enable_pre_call_checks: true
4.3 한도 계산의 전제와 한계
이 계산은 출력이 4096 이하라는 전제 위에 있다. 클라이언트가 max_tokens를 더 크게 보내면 28672 이하의 입력도 창을 넘길 수 있다. 서버 기본값은 max_tokens가 없는 요청에만 적용되기 때문이다. 이 시리즈에서는 LibreChat이 요청을 만들므로 문제가 되지 않았지만, 다른 클라이언트를 붙인다면 게이트웨이에서 max_tokens도 제한해야 한다.
4.4 구성요소별 한도 설정
vllm-mlx, LiteLLM, LibreChat은 각자 컨텍스트 한도를 따로 설정하므로, 이 시리즈에서 사용한 값을 구성요소별로 정리하면 다음과 같다.
| 구성요소 | 설정 | 값 | 근거 |
|---|---|---|---|
| vllm-mlx | VLLM_CONTEXT | 32768 | 시퀀스당 KV cache 한도 |
| LiteLLM | max_input_tokens | 28672 | 32768 − 4096 (출력 예약) |
| LibreChat | tokenConfig context | 24000 | LiteLLM 한도보다 작게, 여유분 |
구성요소마다 토큰을 세는 방식이 달라 같은 입력도 개수가 다르게 나온다. 그래서 앞단(LibreChat)일수록 한도를 낮춰, LibreChat이 보기에 한도 안인 요청이 LiteLLM에서 거절되는 일이 없게 했다. LibreChat 쪽 설정은 5편에서 이어진다.
5. Fallback 설계
fallback과 관련된 설정은 litellm.yaml의 litellm_settings와 general_settings에 나뉘어 있다. litellm_settings에서는 재시도와 장애 대응, 컨텍스트 초과 처리를 정하고, 죽은 모델을 미리 걸러내는 헬스체크는 general_settings에서 켠다(5.4).
litellm_settings:
  drop_params: true
  num_retries: 0
  context_window_fallbacks:
    - gemini-3.5-flash-lite: ["gemini-3.1-flash-lite"]
  fallbacks:
    - gemini-3.5-flash-lite: ["gemini-3.1-flash-lite"]
    - qwen3-8b: ["gemini-3.5-flash-lite"]
장애나 타임아웃이 나면 로컬 모델에서 Gemini로, 다시 Gemini 예비 모델로 이어지고, 입력이 한도를 넘으면 어디로도 넘기지 않고 에러를 반환한다.
qwen3-8b ── 장애/타임아웃 ──► gemini-3.5-flash-lite ── 과부하(503) ──► gemini-3.1-flash-lite
   │
   └── 입력 28672 초과 ──► 에러 반환 (fallback 없음)
5.1 일반 장애 Fallback
fallbacks는 특정 모델의 호출이 실패했을 때 어느 모델로 넘길지를 정하는 규칙이며, 이 설정에는 두 항목이 들어 있다.
- vllm-mlx 장애 또는 무응답 시
qwen3-8b대신gemini-3.5-flash-lite가 응답, 모델 변경을 모르는 채 이어지는 대화 - 상위 Gemini 과부하(503) 시 예비 모델
gemini-3.1-flash-lite로 전환
vllm-mlx를 중지한 상태에서 qwen3-8b로 요청하면 Gemini가 대신 응답한다. 2절의 curl을 그대로 쓰면 되고, model에 gemini-3.5-flash-lite가 찍힌 응답이 돌아온다.
fallback이 일어났는지는 요청 기록에서 확인한다. 응답한 모델이 gemini-3.5-flash-lite로 남지만, 처음 요청한 모델과 fallback 횟수가 함께 기록되기 때문이다.
curl -s http://localhost:4000/spend/logs \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  | jq '[.[] | select(.metadata.attempted_fallbacks > 0)] | last | {model, status, original_model_group: .metadata.original_model_group, attempted_fallbacks: .metadata.attempted_fallbacks}'
{
  "model": "gemini/gemini-3.5-flash-lite",
  "status": "success",
  "original_model_group": "qwen3-8b",
  "attempted_fallbacks": 1
}
처음 요청한 qwen3-8b가 original_model_group에, 실제로 응답한 Gemini가 model에 남고, attempted_fallbacks가 1이면 fallback을 한 번 거쳤다는 뜻이다. qwen3-8b의 실패는 따로 기록되지 않고 요청은 성공 한 건으로 남으므로, Gemini가 대신 응답한 요청은 attempted_fallbacks가 0보다 큰 기록으로 찾는다. 관리 UI(http://localhost:4000/ui)의 Logs에서도 같은 요청을 열어 Metadata에서 볼 수 있다.
5.2 재시도와 Timeout
재시도와 timeout은 실패를 언제 fallback으로 넘길지 정하는 설정이다.
재시도는 실패한 요청을 같은 모델에 다시 보내는 방식이다. 일시적인 네트워크 오류에는 효과가 있지만, 서버가 내려간 경우에는 같은 실패를 반복하며 대기 시간만 늘린다. fallback 모델이 있다면 재시도 없이 바로 넘기는 편이 낫다.
litellm_settings:
  num_retries: 0
num_retries: 0으로 같은 모델에 대한 재시도를 껐다. 에러나 타임아웃이 나면 바로 fallback으로 넘어간다.
Timeout은 응답을 기다리는 최대 시간이다. 서버가 죽었다면 연결이 바로 거절되어 곧장 넘어가지만, 서버는 살아 있는데 응답이 없다면 timeout이 지날 때까지 fallback이 시작되지 않는다. 너무 길면 장애 대응이 늦어지고, 너무 짧으면 느리지만 정상인 요청까지 끊긴다.
model_list:
  - model_name: qwen3-8b
    litellm_params:
      # model, api_base, api_key 생략 (3절과 동일)
      timeout: 30
      stream_timeout: 30
qwen3-8b는 최대 30초까지 기다린다. 스트리밍 요청에는 stream_timeout이 적용되고, 지정하지 않으면 timeout을 따른다. Gemini는 기본값을 그대로 쓴다.
5.3 컨텍스트 초과 시 Fallback 제외
context_window_fallbacks는 컨텍스트 초과 전용 fallback 규칙이다. 이 항목이 없으면 컨텍스트 초과 오류도 일반 fallbacks로 처리되어, 28672토큰을 넘는 요청이 qwen3-8b에서 Gemini로 넘어간다.
litellm_settings:
  context_window_fallbacks:
    - gemini-3.5-flash-lite: ["gemini-3.1-flash-lite"]
  # fallbacks에는 qwen3-8b 항목이 있지만 여기에는 없다
그래서 context_window_fallbacks에는 Gemini 항목만 두고 qwen3-8b는 일부러 뺐다. 항목이 없는 모델은 컨텍스트 초과 시 fallback 없이 에러가 반환되므로, 사용자는 에러를 보게 되지만 문서는 로컬에 남는다. 한도를 넘는 요청을 qwen3-8b로 보내면 다음과 같은 400 에러가 반환된다.
{"error":{
  "message":"litellm.ContextWindowExceededError: litellm.BadRequestError: litellm._pre_call_checks: Context Window exceeded for given call. No models have context window large enough for this call.\nModel=openai/mlx-community/Qwen3-8B-4bit, Max Input Tokens=28672, Got=45196\n\nLiteLLM: model group 'qwen3-8b' failed with the error above. No fallback was attempted.",
  "type":"invalid_request_error",
  "param":null,
  "code":"400"
}}
Max Input Tokens=28672, Got=45196은 입력이 max_input_tokens를 넘었다는 뜻이고, No fallback was attempted.는 Gemini로 넘어가지 않고 에러로 끝났다는 뜻이다. 요청은 vllm-mlx에도 Gemini에도 전달되지 않는다. 이 에러 응답을 가공하는 방법은 5.5절에서 간단히 소개한다.
5.4 헬스체크로 장애 모델 사전 제외
fallbacks는 요청이 실패한 뒤에 동작한다. 그래서 vllm-mlx가 내려가 있어도 매 요청이 먼저 qwen3-8b로 갔다가 실패하고 나서야 Gemini로 넘어간다. 백그라운드 헬스체크는 모델 상태를 미리 점검해 두었다가, 장애 모델을 요청 전에 라우팅에서 빼서 이 실패 시도를 없앤다.
general_settings:
  background_health_checks: true
  health_check_interval: 10
  enable_health_check_routing: true
  background_health_check_model_groups: ["qwen3-8b"]
background_health_checks: 요청과 별개로 모델 상태를 주기적으로 점검health_check_interval: 점검 주기(초), 기본값 300초enable_health_check_routing: 점검에 실패한 모델을 라우팅에서 제외, 타임아웃 대기 없이 바로 fallbackbackground_health_check_model_groups: 점검 대상 모델, 호출 비용이 생기는 Gemini를 제외하고 vllm-mlx만 점검
5.5 참고: 컨텍스트 초과 에러 응답 바꾸기
ContextWindowExceededError가 났을 때 추가 처리를 하거나 에러 메시지를 바꾸고 싶다면 LiteLLM 콜백(CustomLogger)의 async_post_call_failure_hook을 쓸 수 있다. 요청이 실패한 뒤 호출되며, original_exception으로 에러 종류를 확인해 로그를 남기거나 다른 처리를 할 수 있다. 여기서 HTTPException을 반환하거나 raise하면 클라이언트로 나가는 에러 응답이 그 내용으로 바뀌고, None을 반환하면 원래 에러가 그대로 나간다. 이 시리즈에서는 쓰지 않았다.
6. Fallback과 프라이버시의 상충 관계
fallback은 로컬 모델 장애로 대화가 끊기지 않게 해 주지만, 대가가 있다. 장애가 난 순간부터 RAG로 가져온 문서 청크와 대화 내용이 Gemini로 전송된다. “문서와 대화가 외부로 나가지 않는 환경"이라는 이 프로젝트의 출발점과 정면으로 어긋난다. 게다가 사용자는 모델이 바뀐 것을 화면에서 알아채기 어렵다.
| 선택 | 얻는 것 | 잃는 것 |
|---|---|---|
| fallback 사용 | 로컬 서버가 죽어도 대화 지속 | 장애 시 문서·대화가 외부 API로 전송됨 |
| fallback 미사용 | 데이터가 항상 로컬에 남음 | 로컬 서버가 죽으면 대화 중단 |
이 프로젝트에서 데이터가 외부로 나가는지는 GEMINI_API_KEY 설정 여부, 컨텍스트 초과 처리, 장애 fallback의 세 가지에 따라 정해지며, 기본 설정에서는 각각 다음과 같이 동작한다.
- API 키:
GEMINI_API_KEY가 있어야 외부 전송이 가능하다. 키가 없으면 fallback이 일어나도 Gemini 호출이 실패하므로, 프라이버시가 우선이라면 키를 설정하지 않는다. - 컨텍스트 초과: 한도를 넘는 긴 입력은 에러로 끝나고 외부로 자동 전송되지 않는다(5.3절).
- 장애 fallback: 기본으로 켜져 있어서, 키가 있으면 로컬 서버 장애 시 문서가 외부로 전송된다.
데이터를 밖으로 내보내지 않는 것이 목적이라면 fallbacks에서 qwen3-8b 항목을 빼는 편이 맞다. 가용성이 더 중요하다면 fallback을 두되, 어떤 문서가 외부로 나갈 수 있는지를 사용자가 알도록 해야 한다. 이 시리즈에서는 시연 편의를 위해 전자가 아니라 후자에 가깝게 구성했고, 그 선택의 대가를 문서에 남겨 둔다.
7. Admin UI
LiteLLM은 /ui에서 관리 화면을 제공한다. 이 화면은 Postgres에 상태를 저장하므로 DB 연결이 필요하며, compose.yaml에서 다음 두 값이 이를 켠다.
environment:
  DATABASE_URL: postgresql://litellm:password@postgres:5432/litellm # Admin UI(/ui) 사용에 필요
  STORE_MODEL_IN_DB: "True" # UI 에서 모델 추가/수정 허용
- 3편의
pgvector컨테이너 공유와litellmDB 별도 사용,data/postgres가 비어 있을 때 초기화 스크립트가 생성하는 DB와 role - http://localhost:4000/ui 로그인, 사용자명
admin과 비밀번호LITELLM_MASTER_KEY값 - UI의 모델 추가·수정을 허용하는
STORE_MODEL_IN_DB, DB에 저장되어litellm.yaml과 따로 관리되는 UI 추가 모델, 설정이 두 곳으로 나뉘는 혼란을 피하기 위한 파일 기준 운영
관리 UI의 Models 화면에서는 litellm.yaml에 등록한 모델 목록을 확인할 수 있다.
Usage 화면에서는 요청 수, 키별 사용량, 모델별 사용량을 볼 수 있다. 화면은 1편에 있다.
이 시리즈에서 쓸모가 큰 곳은 Logs다. 의도하지 않은 fallback이 일어났는지를 요청 단위로 확인할 수 있기 때문이며, 확인 방법은 5.1절에서 다루었다.
관리 UI는 마스터 키 하나로 열린다. 비밀번호가 .env의 키와 같으니, 외부에 노출하기 전에는 키를 바꾸고 접근을 제한해야 한다. DB 비밀번호(password)도 개발용 placeholder다.
8. 사용자 식별 헤더
LiteLLM 입장에서 요청은 전부 LibreChat 한 곳에서 오므로, 아무 정보가 없으면 “누가 얼마나 썼는지"를 알 수 없다. 그래서 LibreChat이 요청마다 사용자를 식별하는 헤더를 붙인다. config/librechat.yaml의 LiteLLM 엔드포인트 설정이다.
headers:
  x-litellm-end-user-id: "{{LIBRECHAT_USER_EMAIL}}"
x-litellm-end-user-id는 LiteLLM이 최종 사용자를 구분할 때 쓰는 헤더이고, {{LIBRECHAT_USER_EMAIL}}은 LibreChat이 요청하는 사용자의 이메일로 치환하는 자리표시자다. 이제 LiteLLM의 사용량 기록을 사용자 단위로 나눠 볼 수 있다. 로컬 모델은 비용이 들지 않으니, 지금은 누가 얼마나 요청했는지를 보는 용도가 크다. Gemini로 fallback되는 경우의 비용도 사용자별로 귀속된다.
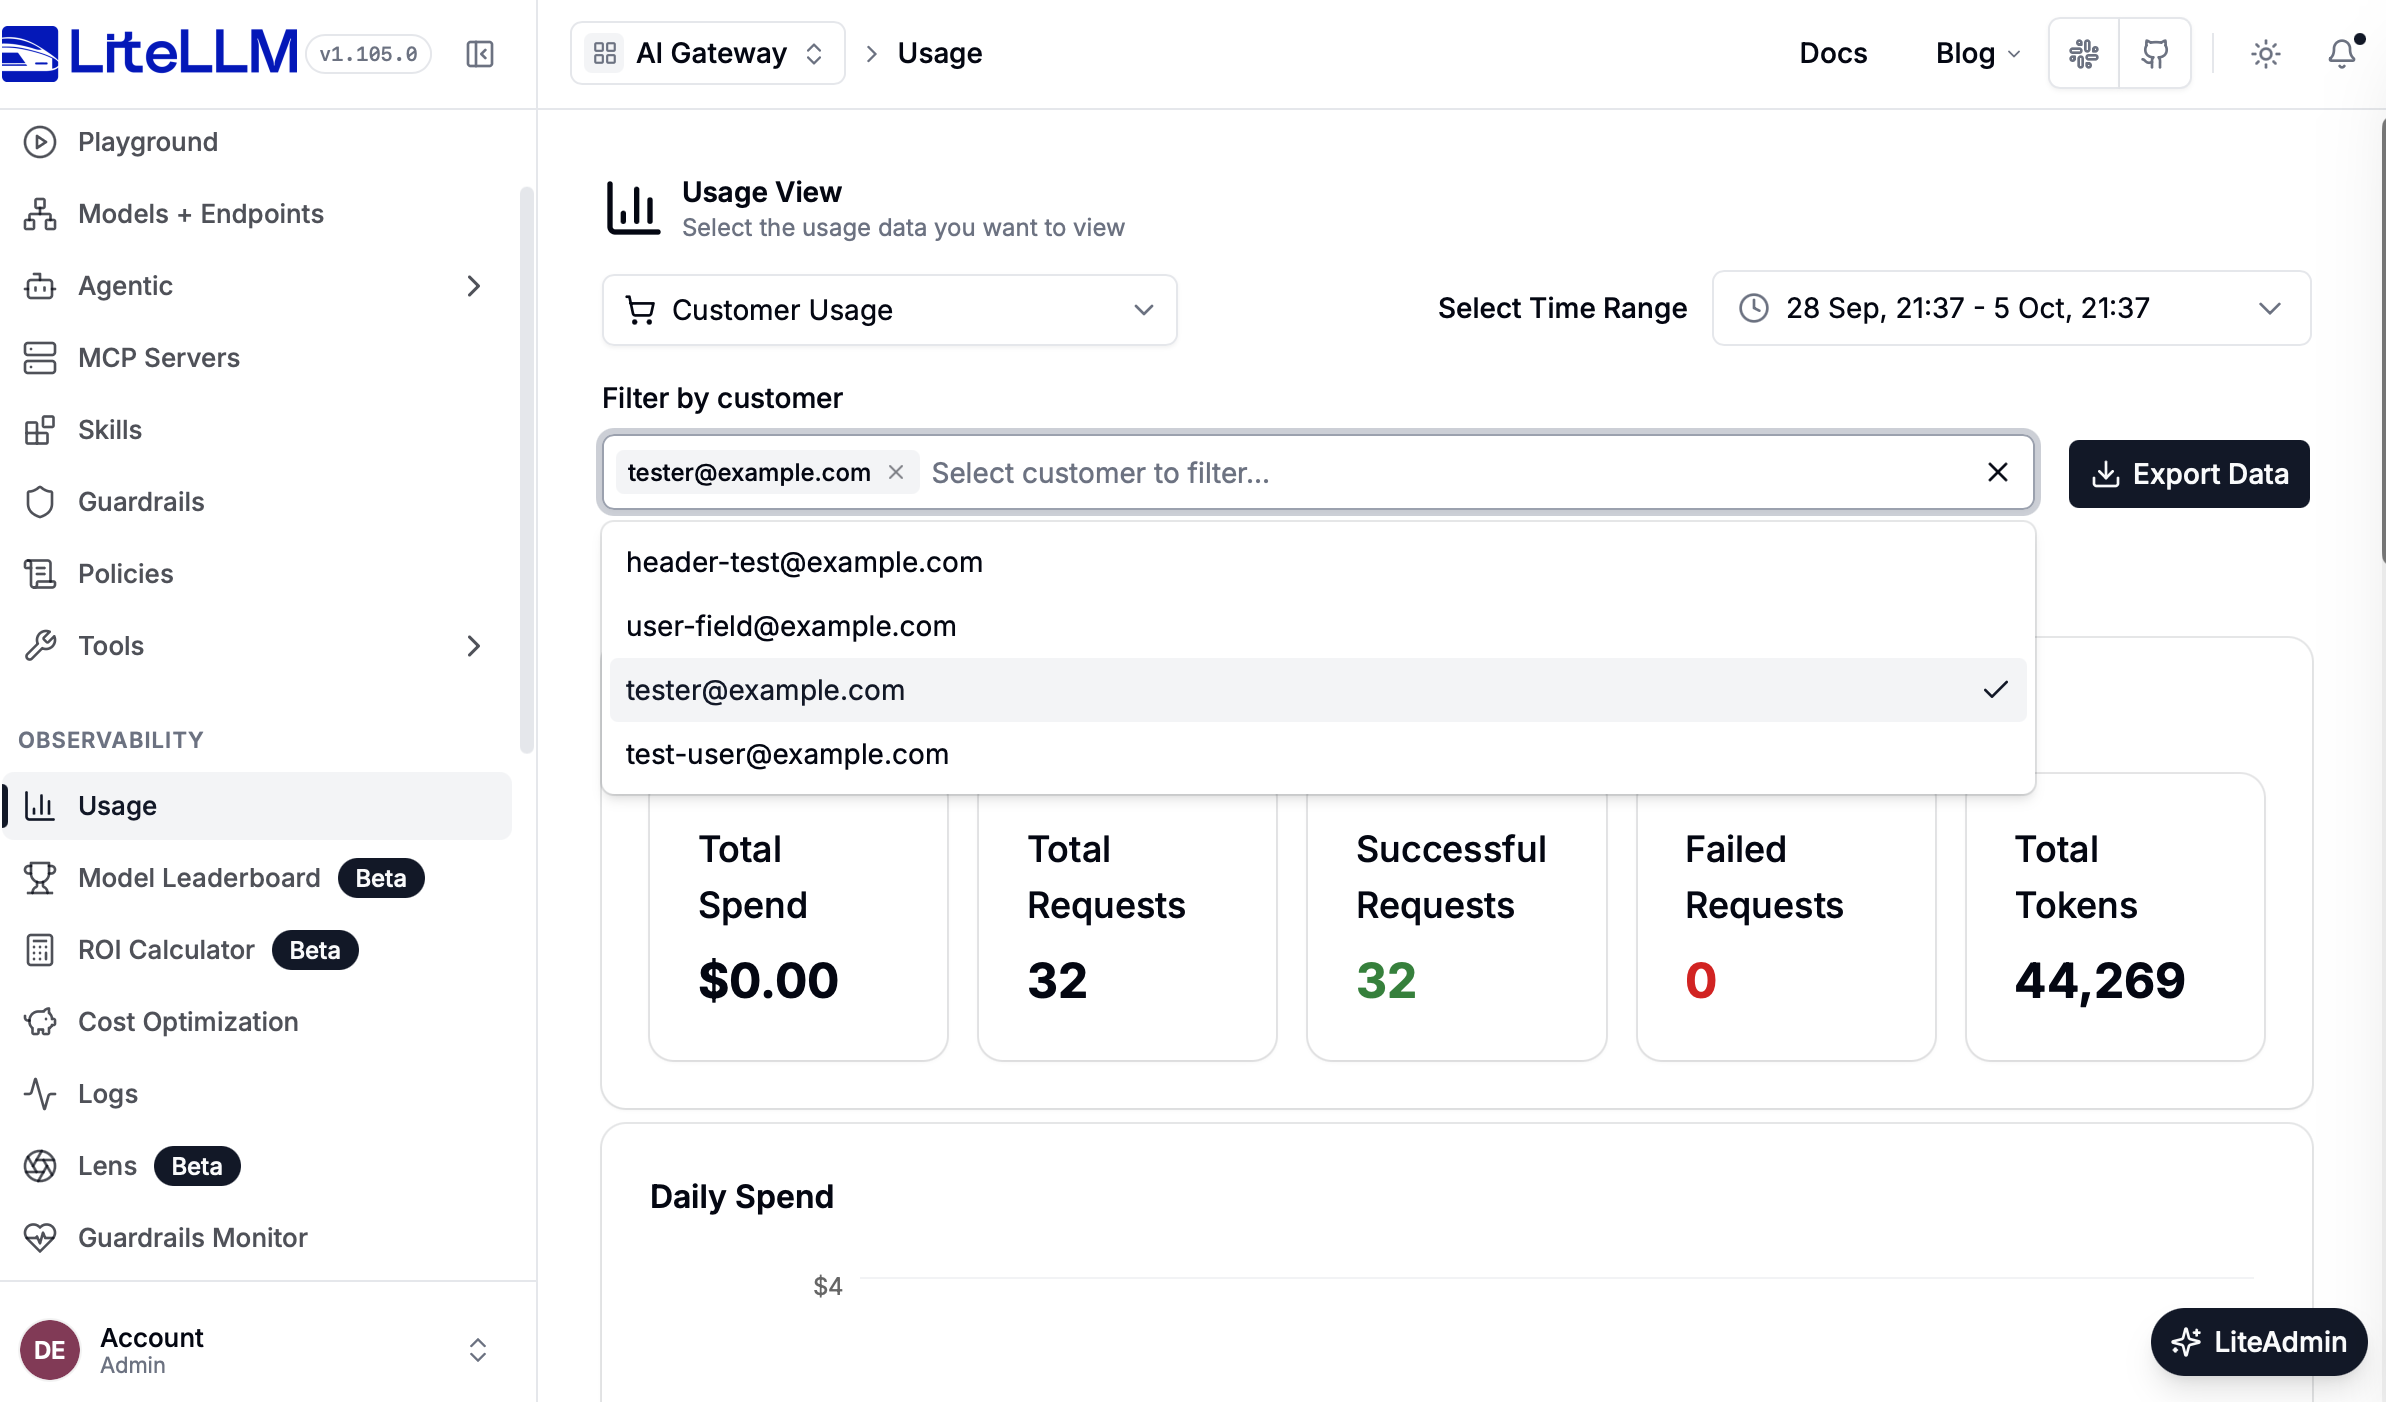
위 화면처럼 Usage의 Customer Usage에서 LibreChat 사용자의 이메일이 고객 목록에 나타나고, 이메일을 선택하여 해당 사용자의 요청 수와 토큰 수만 따로 볼 수 있다.
LibreChat 없이도 같은 헤더를 직접 붙여 curl로 확인할 수 있다. 마스터 키는 2절에서 설정한 LITELLM_MASTER_KEY를 쓴다.
# 1) 사용자 헤더를 붙여 요청
curl -s http://localhost:4000/v1/chat/completions \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -H "x-litellm-end-user-id: test-user@example.com" \
  -d '{"model": "qwen3-8b", "messages": [{"role": "user", "content": "ping"}], "max_tokens": 120}'

# 2) 요청 기록에서 해당 사용자의 가장 최근 항목 확인
curl -s http://localhost:4000/spend/logs \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  | jq '[.[] | select(.end_user == "test-user@example.com")] | last | {request_id, model, end_user, spend}'
end_user에 헤더로 보낸 값이 찍히면 정상이다. 관리 UI(http://localhost:4000/ui)의 Logs에서도 같은 요청을 사용자별로 볼 수 있다. 헤더를 빼고 보내면 end_user가 비어 있어 구분된다. 모델을 gemini-3.5-flash-lite로 바꿔 같은 요청을 보내면 Gemini 호출의 spend가 해당 사용자에게 귀속되는 것도 볼 수 있다.
이 헤더는 사용량을 사용자별로 나눠 볼 수 있게 해 주지만, 개인정보의 보관, 외부 전달 여부, 신뢰성 측면에서 다음 세 가지를 짚어 두어야 한다.
- LiteLLM DB에 기록되는 이메일, 개인정보이므로 DB 접근 권한과 보관 기간의 고려, 이메일 대신 사용자 ID를 쓰는 대안
- fallback 시 Gemini로 가는 요청에 이메일 헤더가 실릴 수 있는 점, 이메일의 외부 전달 여부에 대한 별도 점검
- 인증 수단이 아닌 기록용 헤더, 요청하는 쪽이 채우는 값이라 마스터 키를 아는 클라이언트의 이메일 위조 가능, 접근 통제는 마스터 키와 LibreChat 로그인의 몫
9. 마무리
이 글에서는 LiteLLM을 챗봇과 vllm-mlx 사이의 게이트웨이로 두고, 모델 등록, 입력 한도(max_input_tokens), 장애와 컨텍스트 초과에 대한 fallback, 사용자 식별 헤더를 구성했다. 그리고 fallback이 문서를 외부로 내보내지 않는다는 전제와 부딪히는 지점을 살펴보았다.
실제 운영 환경을 구성한다면, 동시 사용자 수와 문서의 민감도를 고려해 게이트웨이 정책을 정해야 한다.
- 동시 사용자 수 증가에 맞춘 timeout 재조정
- 출력 예약 계산이 깨지지 않도록 하는 클라이언트
max_tokens상한 적용 - 마스터 키 대신 사용자·팀별 가상 키와 예산·속도 제한, 관리 UI와 DB 비밀번호 교체
- 민감한 문서의 fallback 대상 제외, 모델 전환을 사용자에게 알리는 표시
- fallback 발생 알림과 외부로 나간 요청의 기록
- 이메일 대신 사용자 ID 사용, 사용자 식별 정보의 DB 접근 권한과 보관 기간 관리
다음 편
5편에서는 챗봇 UI인 LibreChat을 다룬다. 사용자 등록과 모델 노출, LiteLLM 연동, 그리고 MCP로 simple-rag를 연결하는 방법이다.