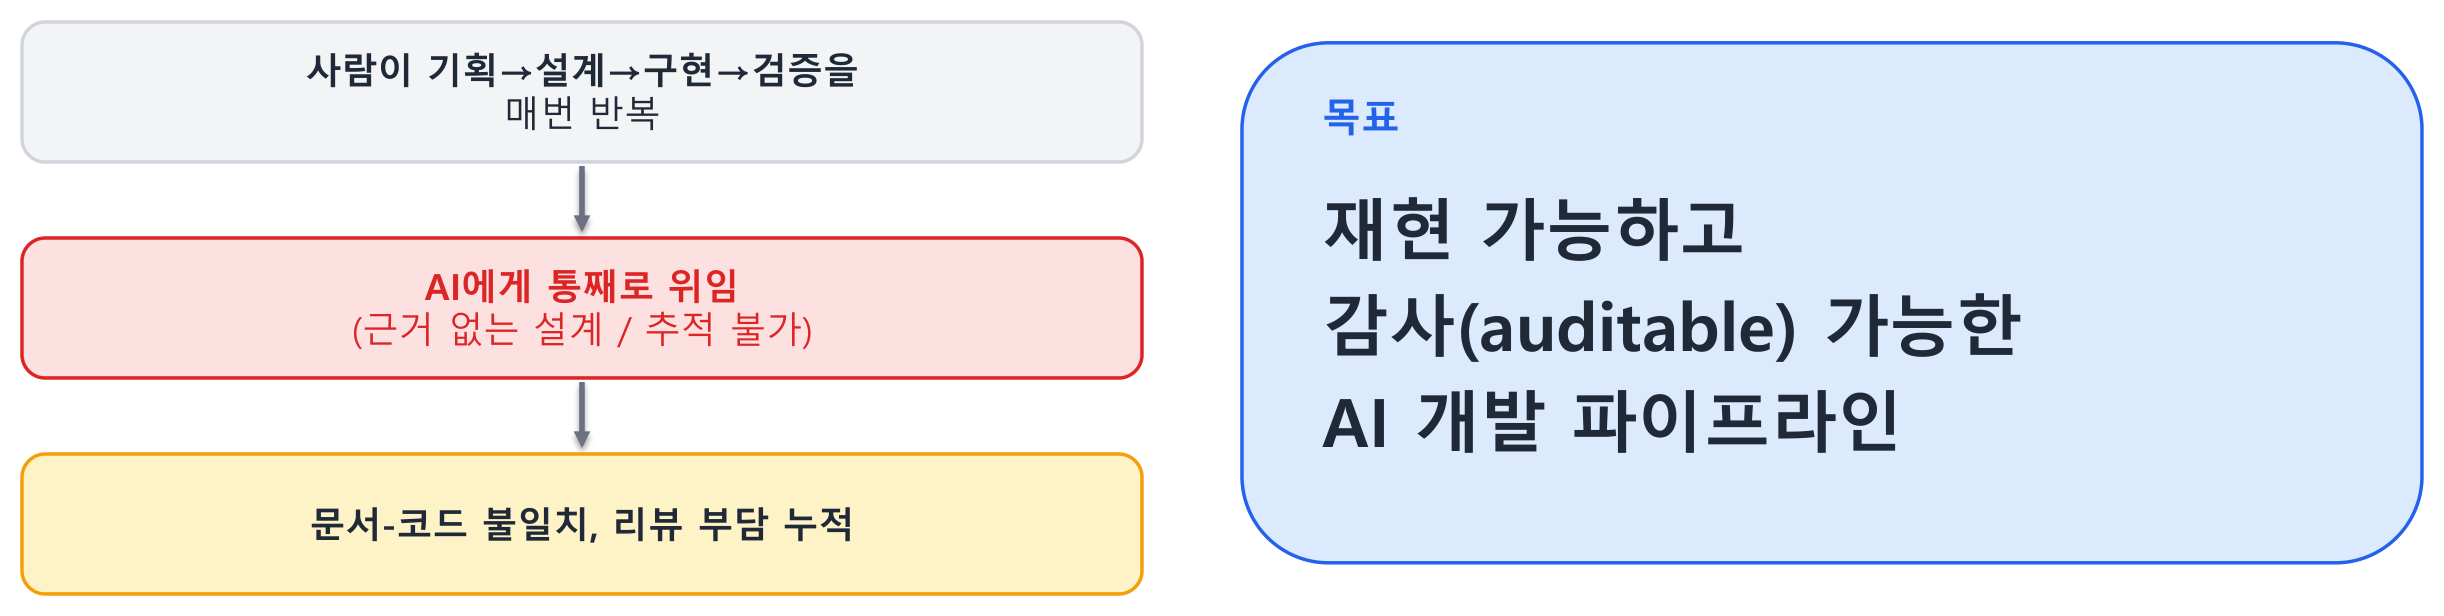
AI에게 코드를 맡기면 속도는 빨라지지만 두 극단 사이에서 흔들리기 쉽다. 한쪽 극단은 AI에게 구현만 맡기고 기획→설계→검증은 사람이 매 단계 직접 수행·확인하는 방식인데, 이러면 AI에게 위임해 얻으려던 속도 이점을 살리지 못한다. 다른 극단은 설계·분석 없이 AI에게 통째로 위임하는 것(이른바 vibe coding)인데, 이 경우 근거 없는 설계와 추적 불가능한 변경이 쌓인다. 문제는 후자다 — vibe coding이 단순히 리뷰 부담만 늘리는 게 아니라는 데 있다.
AI 구현만 맡기고 사람이 매 단계를 직접 수행하는 쪽은 속도에 밀려 문서 갱신이 뒷전으로 밀리기 쉽고, vibe coding 쪽은 애초에 설계 단계 자체가 없다. 설계 단계를 건너뛴 코드는 레이어 경계가 무너지고 중복 로직이 쌓이는 등 구조적인 문제를 남기는데, 당장은 잘 동작해 보여 눈에 띄지 않다가 새 기능을 추가·개선할 때 비용으로, 나아가 버그와 성능 저하로 드러난다. 실제로 CodeRabbit의 PR 470건 분석에서 AI 공동 작성 코드의 로직 결함은 75%, 가독성 문제는 3배 늘었고, vibe coding 프로젝트는 90일 차에 스프린트 역량의 20~30%를 AI발 버그 수정에 쓴다는 조사도 있다. 결국 두 극단 모두 문서와 코드가 어긋나고 리뷰·유지보수 부담만 누적되는 같은 결과로 수렴한다.
이 문제의식은 SpecRelay만의 것이 아니다. GitHub의 Spec Kit, AWS의 Kiro처럼 “AI에게 통째로 위임하되 spec → design → tasks → implement로 이어지는 구조를 강제한다"는 접근이 2026년 들어 spec-driven development라는 이름으로 여러 곳에서 독립적으로 수렴하고 있고, 초기 도입 사례들은 비trivial task에서 AI의 1차 성공률이 3~10배 높아졌다고 보고한다. 접근 없이 되는대로 구현하는 방식과 사람이 매 단계 직접 수행하는 방식 사이에서, “설계 산출물을 문서로 강제하고 게이트를 통과해야만 다음 단계로 넘어가게 한다"는 세 번째 축이 업계 전반에서 검증되고 있는 셈이다.
SpecRelay는 이 문제를 풀기 위해 RAG-API 프로젝트(github.com/cnapcloud/rag-api)에서 자체적으로 만든 .claude 기반 워크플로우다. 핵심 설계는 하나다 — “기계적 절차는 command가, 판단이 필요한 콘텐츠는 agent(서브에이전트)가” 엄격히 나눠 맡는다. 브랜치 생성, 번호 채번, 상태 갱신처럼 규칙만 따르면 되는 일은 커맨드가 직접 처리하고, spec 작성·설계·구현·검증처럼 판단이 필요한 일만 전용 서브에이전트를 호출해 맡긴다. 이 분리 덕분에 AI에게 개발을 위임하면서도 각 단계가 왜 그렇게 진행됐는지 언제든 되짚을 수 있는, 재현 가능하고 감사(auditable) 가능한 파이프라인이 만들어진다.
이 글에서는 RAG-API 프로젝트의 .claude/ 디렉토리에 실제로 구현된 커맨드·에이전트·스킬·스펙 파일을 근거로 SpecRelay가 어떻게 동작하는지 정리한다.
목차
- 왜 SpecRelay가 필요한가
- 전체 흐름 한눈에 보기
- 아키텍처 — commands / agents / skills / specs
- Step 1: spec-new — 시작 게이트
- Step 2: spec-design — 설계 산출물
- Step 3: spec-implement — Task 단위 구현
- Step 4: spec-validate & spec-pr — 검증과 병합
- 상태 관리 — specs/index.md
- 안전장치 — 하드 룰
- 지식 재사용 — Skills
- 메모리 시스템
- 실전 사례 — US-53 검색 캐시
- 마치며
1. 왜 SpecRelay가 필요한가
AI에게 구현만 맡기고 기획→설계→검증은 사람이 매번 처음부터 끝까지 직접 수행·확인하는 방식은 AI에게 위임해 얻으려던 속도를 살리지 못하고, 속도에 밀려 문서 갱신부터 뒷전으로 밀리기 쉽다. 반대로 설계·분석 없이 AI에게 전 과정을 통째로 맡기면 근거 없는 설계와 추적 불가능한 변경이 쌓인다. 두 극단이 결국 같은 자리 — 문서와 코드가 어긋나고 리뷰 부담만 누적되는 상태 — 로 수렴한다는 것은, 필요한 게 그 중간, 즉 설계 산출물을 spec 문서로 강제하고 게이트를 통과해야만 다음 단계로 넘어가게 하는 spec 기반 AI 개발이라는 뜻이다.
그렇다면 왜 GitHub Spec Kit 같은 검증된 오픈소스 spec-driven 툴킷을 그대로 쓰지 않고 SpecRelay를 자체 개발했는가. 같은 조직의 자매 프로젝트에서 동일한 요구사항(사용자 목록 조회 API)을 Spec Kit 표준 7단계, Spec Kit 경량화 5단계, 자체 개발한 4-커맨드 워크플로우 세 갈래로 각각 구현해 비교한 적이 있는데, 이 실험이 SpecRelay의 설계 방향을 그대로 뒷받침한다.
- 비용 — 게이트(단계) 수가 적을수록 턴 수·토큰 비용이 준다. 같은 요구사항으로 SpecRelay와 speckit을 실측 비교하면 speckit이 약 2배 더 든다(표는 문서 하단 부록 참고).
- 커스터마이즈 — Spec Kit은 “이번엔 clarify 생략” 같은 프로젝트별 판단을 매번 사람이 지시문으로 다시 넣어야 한다. 자체 워크플로우는 이런 판단(RAG-API 레이어 규칙, 실제 테스트 명령, spec.md 작성 원칙 등)을 커맨드·스킬에 아예 못박아 둔다.
- 품질 — 도구보다 확인 절차(승인 게이트) 유무가 품질을 가른다. spec.md의
## 승인체크박스 단계에서 사용자의 검토를 통해, 비용을 줄여도 품질은 지킬 수 있다.
정리하면 SpecRelay를 자체 개발한 이유는 Spec Kit이 부족해서가 아니라, RAG-API 고유의 판단을 커맨드에 못박아 비용을 줄이면서도 승인 게이트는 그대로 유지하기 위해서다. 목표는 명확하다. 재현 가능하고 감사 가능한 AI 개발 파이프라인. 이를 위해 SpecRelay는 두 가지 원칙을 지킨다.
- 모든 산출물(spec.md, design.md, task.md, implementation.md, validation.md)은 파일로 남아, 세션이 끝나도 “왜 이렇게 결정했는지"를 다시 읽을 수 있다.
- 모든 단계 전환은 승인 체크박스나 CI 게이트를 통과해야만 다음으로 넘어간다 — AI가 스스로 다음 단계로 건너뛸 수 없다.
2. 전체 흐름 한눈에 보기
세부 단계로 들어가기 전에, 기능 하나가 요청부터 main 반영까지 거치는 전체 경로를 먼저 짚고 넘어간다. “검색 결과 캐싱 추가” 같은 요청 한 줄이 어떤 문서와 어떤 게이트를 거쳐 실제 코드로 살아남는지, 그 흐름은 아래처럼 6단계로 고정되어 있다.
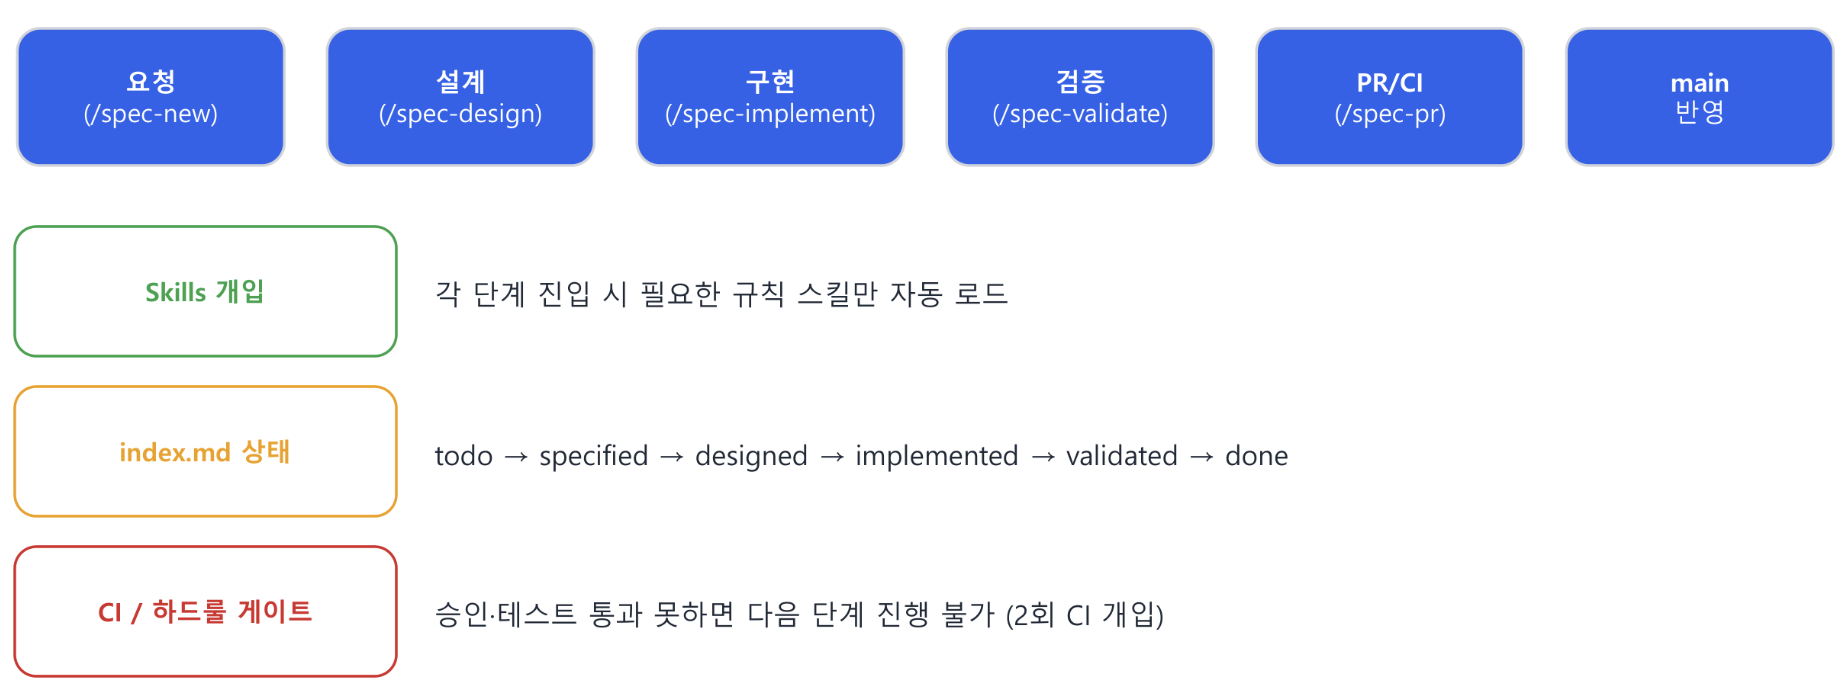
이 6단계가 실제로 진행되는 동안에는 아래 세 가지 장치가 각 전환 지점에서 함께 작동한다.
| 장치 | 역할 |
|---|---|
| Skills 개입 | 각 단계 진입 시 필요한 규칙 스킬만 자동 로드 — 에이전트 frontmatter의 skills: 목록에 있는 것만 |
| index.md 상태 | todo → specified → designed → implemented → validated → pr_requested → (History로 이동 = done) |
| CI / 하드룰 게이트 | 승인·테스트를 통과하지 못하면 다음 단계 진행 불가 (PR 시점 + merge 시점, 2회 CI 개입) |
3. 아키텍처 — commands / agents / skills / specs
앞서 본 6단계 흐름을 실제로 움직이는 것은 네 개의 계층이다. 이 계층 구조가 곧 “기계적 절차는 command가, 판단은 agent가” 원칙을 코드로 구현한 형태이며, 이후 모든 Step 설명은 이 네 계층이 서로 어떻게 호출하고 산출물을 주고받는지를 구체화한 것에 지나지 않는다.
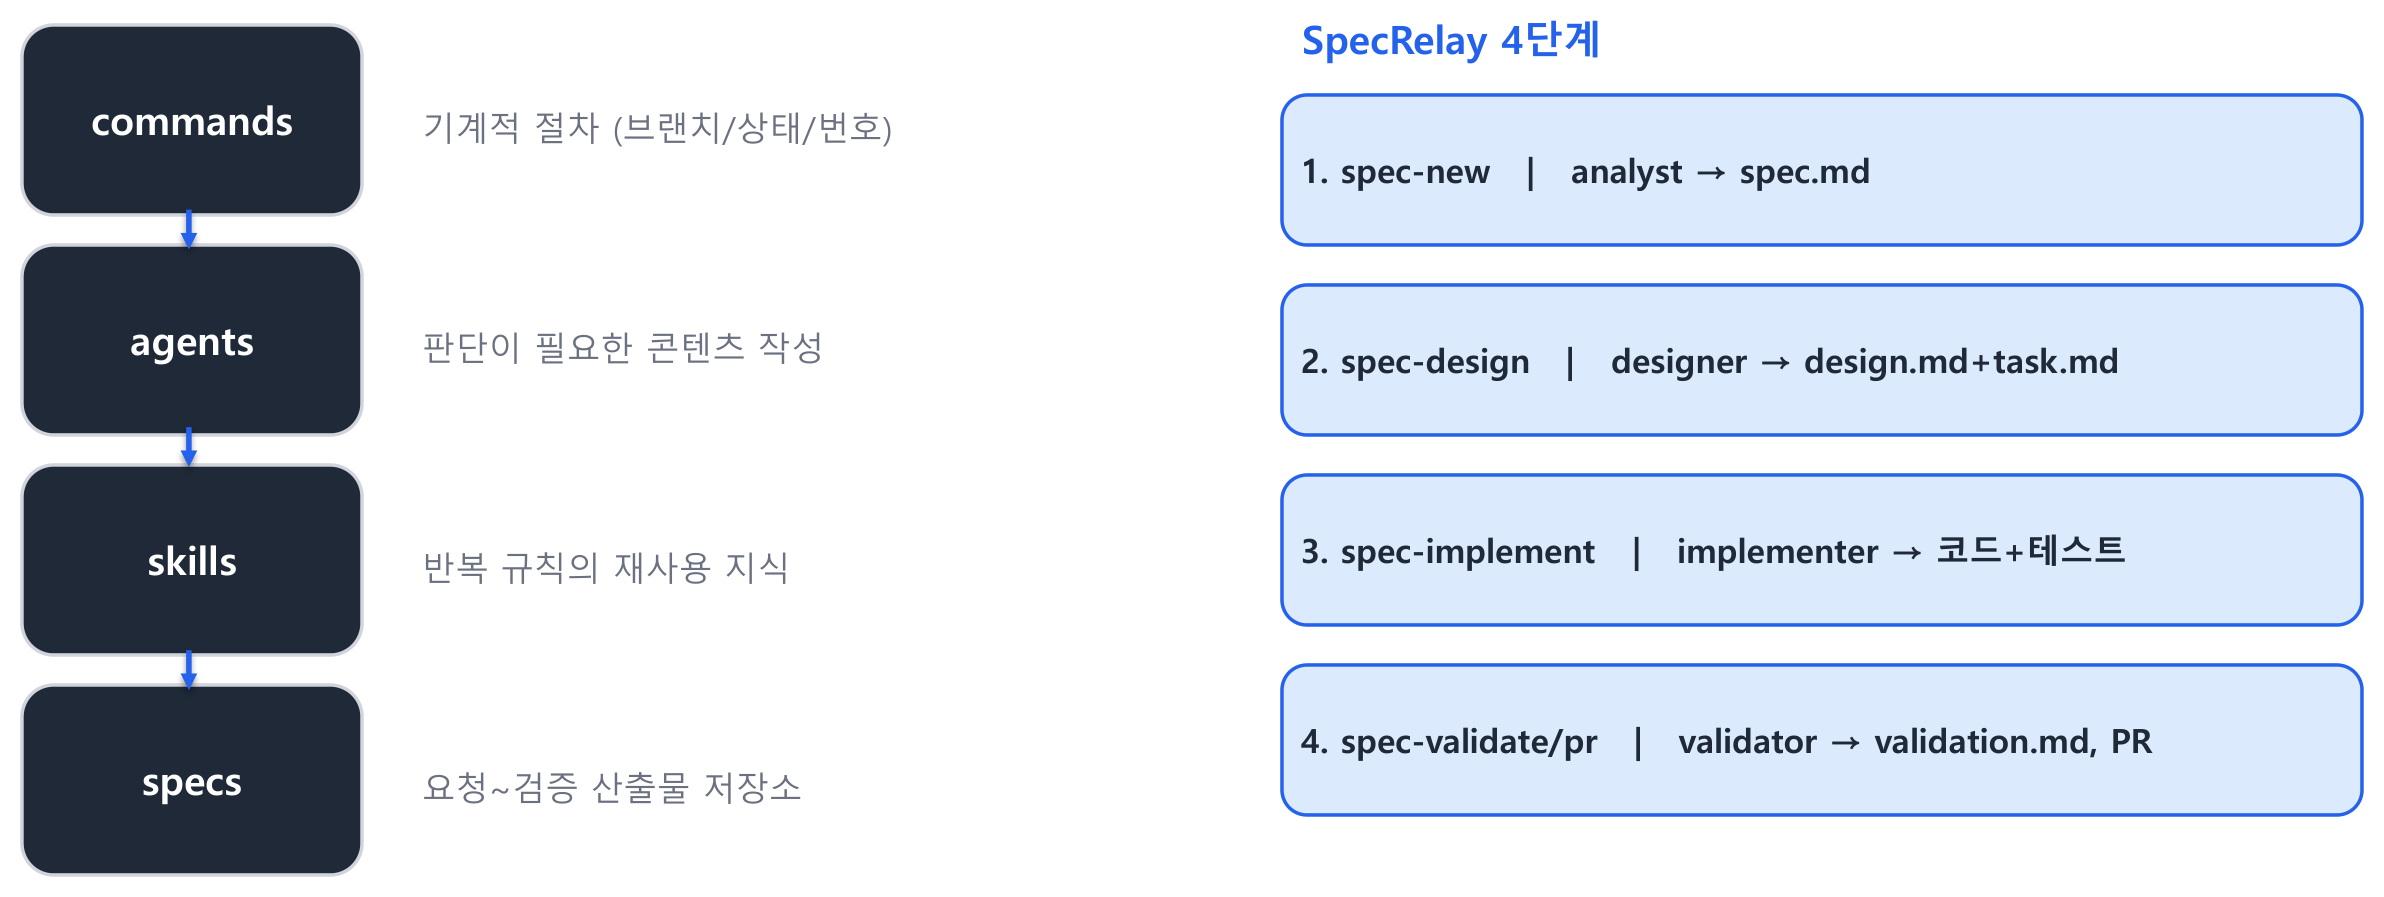
commands는 브랜치·번호·상태 갱신 같은 기계적 절차를(.claude/commands/spec-new.md 등 6개), agents는 판단이 필요한 콘텐츠 작성을(.claude/agents/analyst.md 등 4개), skills는 반복 규칙의 재사용 지식을(.claude/skills/architecture/ 등 8개), specs는 요청부터 검증까지의 산출물을(.claude/specs/US-NN-*/) 각각 맡는다.
SpecRelay는 4단계로 구성되며, 각 단계는 다음과 같은 산출물을 남긴다.
spec-new— analyst →spec.mdspec-design— designer →design.md+task.mdspec-implement— implementer → 코드 + 테스트 +implementation.mdspec-validate/spec-pr— validator →validation.md, GitHub PR
각 커맨드는 서브에이전트를 호출하기 전후로 반드시 기계적 검증을 거친다. 예를 들어 spec-design.md는 designer를 부르기 전 spec.md의 ## 승인 체크박스가 [x]인지 직접 확인하고, designer가 돌아온 뒤에는 index.md의 Status를 designed로 갱신한다 — 어느 것도 서브에이전트가 스스로 하지 않는다. 판단(설계 내용)과 절차(상태 갱신)를 명확히 분리해, 서브에이전트가 산출물 내용에만 집중하고 워크플로우 무결성은 커맨드가 담보한다.
4. Step 1: spec-new — 시작 게이트
모든 spec은 예외 없이 이 게이트를 통과해야 시작된다. 브랜치 생성·번호 채번·폴더 준비처럼 판단이 필요 없는 절차는 커맨드가 직접 기계적으로 처리하고, “무엇을 완료로 볼 것인가"라는 내용 판단만 analyst 서브에이전트에게 넘겨, 시작 단계부터 절차와 판단이 뒤섞이지 않도록 한다.
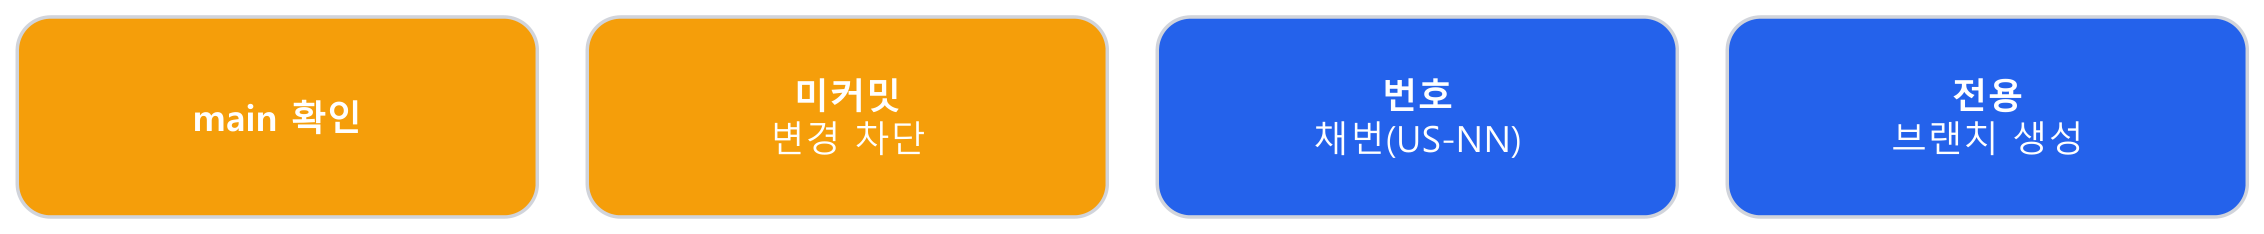
/spec-new는 main 브랜치가 아니면 시작 자체를 거부한다. 커밋 안 된 변경이 있어도 멈춘다 — 자동으로 커밋하거나 스태시하지 않고 사용자가 직접 정리하게 둔다. 이후 절차는 전부 기계적이다.
git pull --ff-only로 main을 최신화 (fast-forward 실패 시 중단).claude/specs/index.md의 “마지막 채번 번호” + 1과,git branch -a에서 뽑은US-<N>최댓값 + 1을 비교해 더 큰 쪽으로 번호(US-NN) 확정 — 여러 spec이 동시에 다른 브랜치에서 진행 중이어도 번호가 겹치지 않도록 하는 장치다<type>/US-NN-<slug>브랜치 생성- index.md에
| US-NN | 요청 원문 | todo |행을 analyst 호출 전에 먼저 기록 — 세션이 중간에 끊겨도 이 번호가 “이미 쓰인 상태"로 남게 하기 위함
이어서 analyst 서브에이전트가 호출되어 완료 기준(AC)을 명시한 spec.md를 작성한다. analyst는 요청이 기존 아키텍처·데이터 스키마와 모순되는지(architecture 스킬), 이미 있는 spec과 중복되는지(index.md Title 비교)를 먼저 확인하고, 모호하면 spec.md를 쓰지 않은 채 질문을 반환한다 — 임의로 하나를 골라 진행하지 않는다.
spec.md에는 원칙이 하나 있다: 소스코드·테스트 코드 정보를 기술하지 않는다. 파일명, 클래스/함수명, “어떻게 고칠지"는 전부 design.md·task.md의 몫이다. spec.md는 오직 “무엇을 완료로 볼 것인가"만 담고, 세부 기능(F1, F2, …) 각각에 F1-1, F1-2 같은 AC ID가 붙는다 — 이 ID는 이후 designer/implementer/validator가 그대로 참조하므로 한 번 붙으면 재번호를 매기지 않는다.
spec.md에 ## 승인 체크가 없으면 다음 단계(design)로 진입할 수 없다. 체크박스는 이 세션(커맨드)이 직접 [x]로 바꾼다 — analyst가 스스로 승인하는 셀프 승인은 금지되어 있다.
5. Step 2: spec-design — 설계 산출물
spec.md가 “무엇을 완료로 볼 것인가"만 정했다면, 이 단계는 그것을 “어떤 구조로, 어떤 순서로” 만들지 결정하는 단계다. designer 서브에이전트가 실제 코드를 읽어 영향 범위를 확정하고, 이후 implementer가 그대로 따라갈 수 있도록 설계와 작업 분리를 문서로 남긴다.
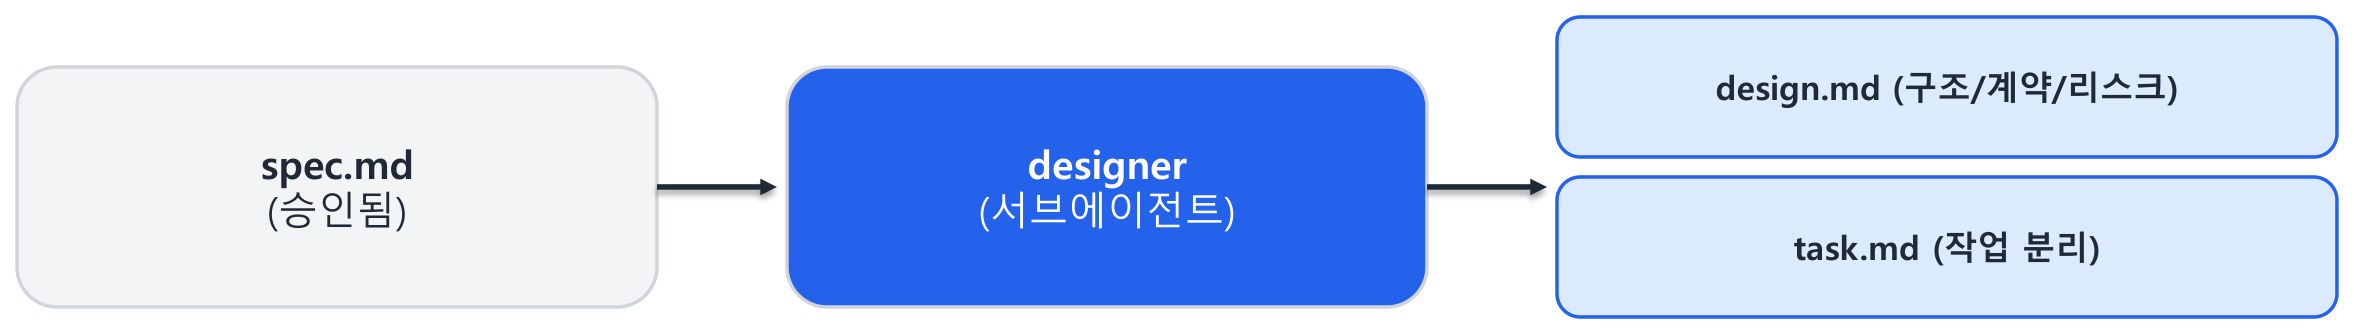
승인된 spec.md를 받아 designer 서브에이전트가 두 문서를 만든다.
- design.md — 아키텍처 개요, 영향 레이어/파일, API 계약/데이터 모델/에러 모델/로깅/NFR, 리스크&롤백.
architecture스킬의 레이어 표·의존성 방향 기준으로 실제 코드를 Read해서 채운다 — 추측 금지. - task.md — spec.md의 AC 단위(F1-1, F1-2, … / C1, C2, …)로 대응되는 vertical slice 작업 목록. 완료 기준이 1개뿐이어도 최소 1개 task로 표현해야 하며, task 하나마다 “관련 파일"과 구현 방법(건드릴 함수/클래스, 순서, 주의사항)을 구체적으로 적는다.
designer가 spec.md와 기존 코드/아키텍처가 근본적으로 충돌하는 지점을 발견하면, design.md/task.md를 채우지 않고 모순/블로킹 이슈로 보고한다. 커맨드는 이 내용을 사용자에게 그대로 전달하고, spec.md 수정 여부를 확인한 뒤에야 다시 진행한다 — designer가 임의로 spec.md를 고치지 않는다.
완료 기준 커버리지도 기계적으로 대조한다: spec.md의 전체 AC를 task.md “완료 기준 커버리지” 표와 맞춰봐서, 어느 task에도 속하지 않은 AC가 있으면 그 자리에서 채워 넣는다. 이 단계에는 architecture, traceability 스킬이 적용되어 레이어 의존성 위반을 사전에 차단한다.
6. Step 3: spec-implement — Task 단위 구현
설계가 끝나면 이제 코드를 쓸 차례다. implementer 서브에이전트는 새로 설계하지 않고 task.md에 이미 정해진 순서·구조대로만 구현하며, task 하나가 끝날 때마다 확인 절차 없이 다음 task로 자동 진행되기 때문에 각 task의 독립성과 실패 처리 방식이 특히 중요하다.

task.md로 분리된 작업은 Task 1 → Task 2 → Task 3 순서로 진행된다. 각 task 처리 절차는 다음과 같다.
- 상태를
in-progress로 갱신 - 신규 의존성이 있으면
uv add <pkg>부터 실행 conventions/import-paths/exception-handling/logging스킬과 CLAUDE.md 하드 룰을 지켜 코드 작성uv run pytest -q <경로>로 테스트 실행- 실패 시 세 갈래로 분류
- task 범위 안의 버그 → 스스로 고쳐 통과
- 사실 드리프트(design.md가 가리키는 대상이 바뀌었을 뿐, 레이어/접근 방식은 유효) → 해당 부분만 고쳐 맞추고 계속 진행
- 그 외(설계 결정 필요, 반복해도 안 풀림) → 코드/문서를 고치지 않고 정지
- 통과하면
done으로 갱신하고 “진행 기록"에 매핑된 AC + 테스트 결과를 append
막히면(blocked) 이유를 유형으로 분류해 이전 단계로 되돌린다 — [설계] 유형이면 design.md가 잘못됐다는 뜻이라 /spec-design을 다시 타야 하고, [구현] 유형이면 설계는 맞지만 구현에서 막힌 것이라 /spec-implement를 재실행한다. 이 유형 분류가 있어서, 문제가 생겼을 때 정확히 어느 단계로 돌아가야 하는지 사람이 판단하지 않아도 된다. 실패해도 자동 재시도는 없다 — 항상 사용자 지시를 받은 뒤에만 커맨드를 재실행해 다시 호출한다.
7. Step 4: spec-validate & spec-pr — 검증과 병합
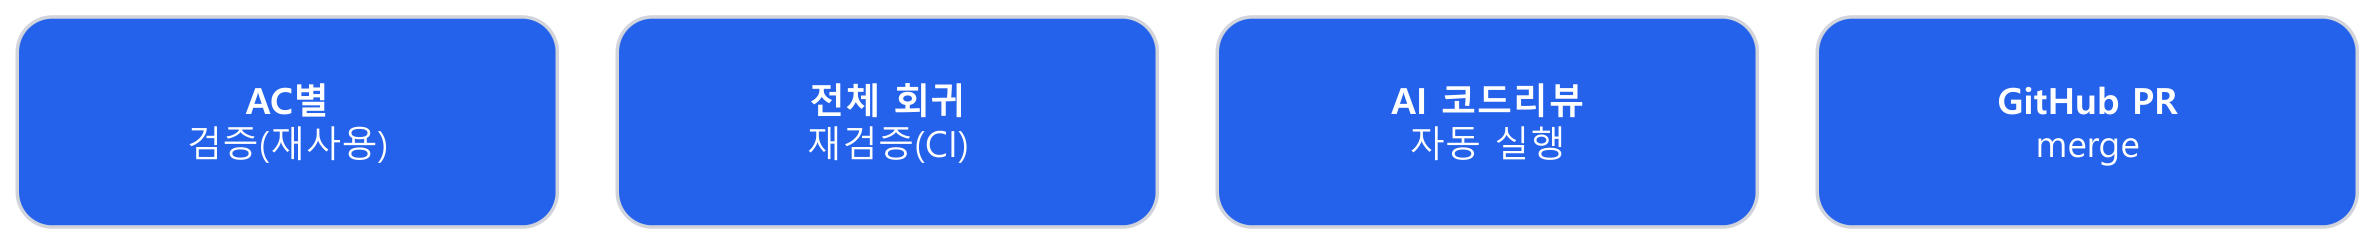
구현이 끝났다고 곧바로 끝이 아니다. spec.md의 완료 기준(AC)을 하나하나 실제로 재검증하는 관문을 통과해야 PR이 열리고, 그 PR도 GitHub CI를 통과해야만 비로소 main에 들어간다 — 이 마지막 단계는 validate(검증)와 pr(병합)이라는 서로 다른 책임을 가진 두 커맨드로 나뉜다.
7-1. spec-validate
validator 서브에이전트가 하는 일은 검증뿐이다 — 실패해도 코드를 고치지 않는다.
- spec.md의 모든 AC ID를 뽑아 task.md “완료 기준 커버리지” 매핑과 함께 정리
- architecture 재검증: design.md의 “영향 레이어/파일” 판단을
architecture스킬 기준으로 다시 검사 — implementer는 이 스킬을 쓰지 않으므로, 레이어 판단 오류를 걸러내는 마지막 지점이 여기다. 역방향 참조가 있으면 해당 AC를[설계]FAIL 후보로 표시 - AC별로 실제 테스트를 재실행해 PASS/FAIL 판정 (실패는
[구현]FAIL) - 전체 회귀 검증:
make test/make lint/make typecheck를 spec.md AC 체계와 별개로 실행 — 회귀가 하나라도 있으면 전체 판정은 FAIL - PASS인 AC만 spec.md에서
[x]로 갱신, FAIL은 이미 체크돼 있었어도 다시 미체크로 되돌림(회귀 가능성 반영)
전체 통과 시에만 index.md Status가 validated로 바뀐다. 실패는 regression-triage 스킬 기준으로 [설계]/[구현]/매핑 없음 세 목록으로 분류되어 기록된다.
7-2. spec-pr
/spec-pr는 서브에이전트를 호출하지 않는다 — git/GitHub 작업만 기계적으로 처리한다. 로컬에서 main으로 직접 merge하지 않고, merge는 오직 GitHub PR을 통해서만 이뤄진다.
validated상태 → 브랜치 push → PR 생성 →code-review스킬로 AI 코드리뷰를medium레벨로 실행(인라인 코멘트만, merge를 막지는 않음) → Status를pr_requested로 전환pr_requested상태 →gh pr view로 CI 체크 확인 → 전부SUCCESS면 사용자에게 merge 여부를 물어봄 → 승인 시index.md의 해당 행을 “진행 중"에서 “History"로 옮기고 커밋 →gh pr merge로 실제 병합
PR 생성 전 로컬 dry-run은 없다 — main과의 통합 검증은 GitHub CI가 전담한다.
8. 상태 관리 — specs/index.md
지금까지 나온 모든 상태 전환(todo→specified→designed→…)은 결국 이 파일 하나에 기록된다. spec.md나 design.md 어디에도 별도 상태 필드를 두지 않는 이유는, 여러 spec이 서로 다른 브랜치에서 동시에 진행될 때 상태를 확인할 곳이 하나로 고정돼 있어야 번호 충돌이나 진행 상황 불일치가 생기지 않기 때문이다.

specs/index.md는 유일한 상태 저장소다. spec.md에는 별도 상태 필드를 두지 않는다 — “진행 중” 표와 History만 신뢰한다.
| Status | 완료된 단계 |
|---|---|
todo | (없음 — 방금 생성됨) |
specified | spec.md |
designed | design.md/task.md |
implemented | 전체 task |
validated | AC 전수 검증 통과 — /spec-pr로 PR 생성 대기 |
pr_requested | GitHub PR 생성됨 — 실제 merge 대기 |
blocked | 설계/구현/검증/merge 중 이슈로 정지 |
done은 별도 상태값이 아니다 — PR이 실제로 merge된 것까지 확인한 순간, 해당 행이 “진행 중” 표에서 지워지고 History 표로 옮겨지는 것 자체가 완료를 표현한다. 번호 채번 로직도 이 파일의 “마지막 채번 번호” 필드 하나만 보고 정하기 때문에, 여러 spec이 각자 브랜치에서 동시에 진행되어도 번호 충돌이 나지 않는다.
읽기 전용 조회도 가능하다. /spec-status는 아무것도 쓰지 않고 spec.md/design.md/implementation.md/validation.md를 순서대로 읽어 “지금 어느 단계에 멈춰 있고 다음에 뭘 해야 하는지"를 판정해 보여준다.
9. 안전장치 — 하드 룰
지금까지의 게이트가 “다음 단계로 언제 넘어갈 수 있는가"를 정했다면, 하드 룰은 “AI가 어떤 상황에서도 넘지 말아야 할 선"을 정한다. 판단 오류는 서브에이전트가 검증 단계에서 걸러낼 수 있지만, 승인 없는 커밋이나 로컬 merge 같은 되돌리기 어려운 행동은 애초에 발생하지 않도록 막아야 하기 때문이다.
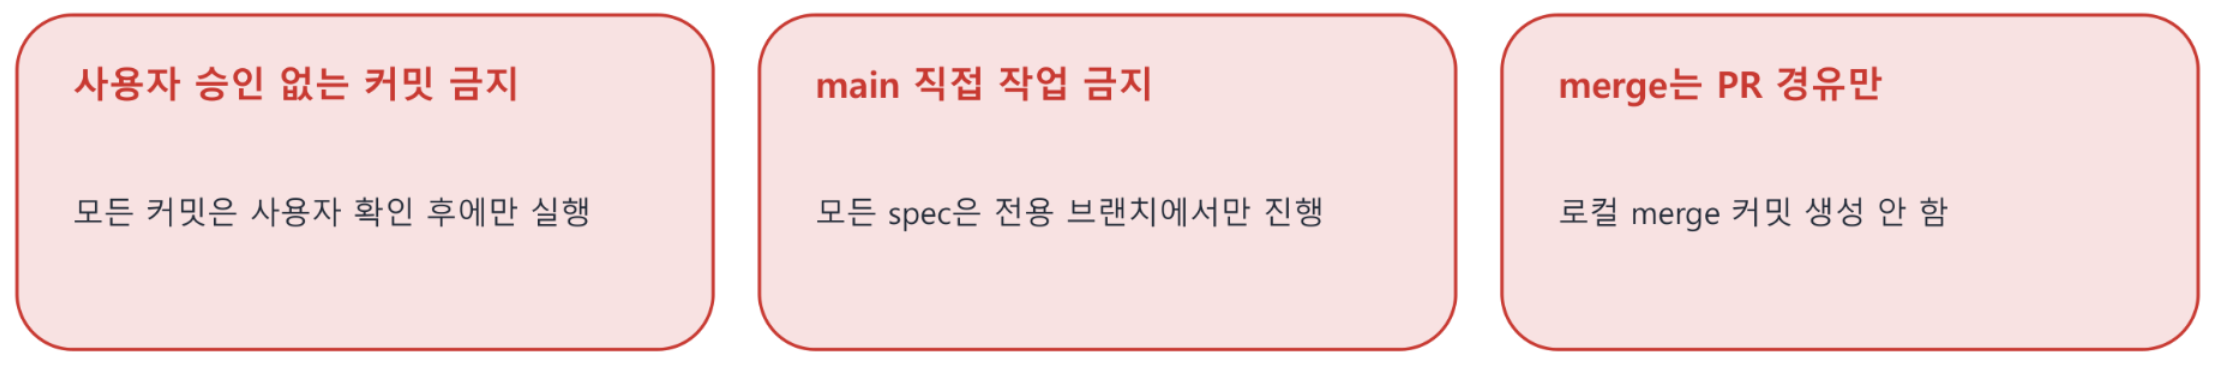
- 사용자 승인 없는 커밋 금지 — 모든 커밋은 사용자 확인 후에만 실행
- main 직접 작업 금지 — 모든 spec은 전용 브랜치에서만 진행
- merge는 PR 경유만 — 로컬 merge 커밋을 생성하지 않음
실패 시 자동 재시도는 없다. 항상 사용자 지시를 받은 뒤에만 재실행하도록 인간 개입 지점을 명시해 둔다. 이 원칙이 왜 필요한지는 뒤(11절)에서 실제 재발 사례로 다시 다룬다 — 하드 룰로 명시해 둬도 세션 관성 때문에 어길 수 있다.
10. 지식 재사용 — Skills
앞서 각 Step 설명에 반복해서 등장한 architecture, conventions, traceability 같은 이름들이 바로 스킬이다. 레이어 구조나 예외 처리 규칙처럼 매 세션 새로 설명해야 했던 반복 지식을 파일 하나로 압축해 두면, 필요한 에이전트만 그 파일을 자동으로 불러 쓸 수 있다.
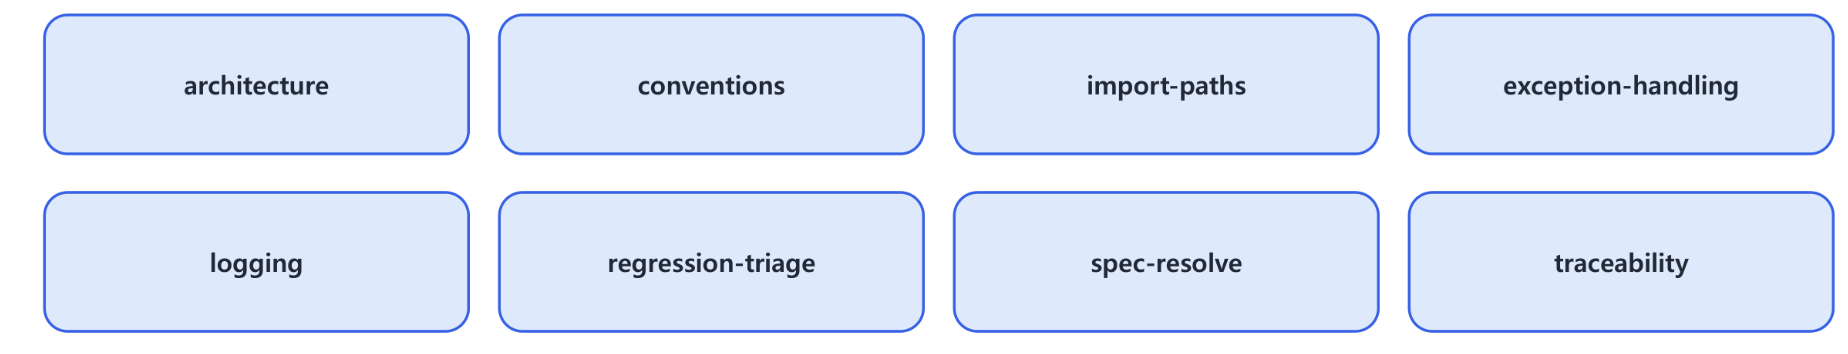
실제로 RAG-API에는 8개 스킬이 있고, 에이전트별 frontmatter의 skills: 목록에 있는 것만 선택적으로 자동 로드된다.
| Skill | 용도 | 주 사용자 |
|---|---|---|
architecture | 레이어 구조·의존성 방향 위반 확인 | analyst, designer, validator |
conventions | 하드 룰 상세(설정/infra/순수함수/로그/커밋) + 테스트 가이드 | implementer |
import-paths | 모듈 import 경로 규칙 | implementer |
exception-handling | 예외 계층과 레이어별 처리 규칙 | implementer |
logging | 로거 선언·레벨·메시지 포맷 | implementer |
regression-triage | 실패를 [설계]/[구현]/매핑 없음으로 분류 | validator, spec-pr |
spec-resolve | $ARGUMENTS로 spec 폴더 확정 + 브랜치 확인 | 4개 커맨드 공통 |
traceability | spec/design 문서 간 링크 포맷과 추적성 규칙 | analyst, designer |
에이전트마다 필요한 스킬만 골라 쓴다는 점이 중요하다. 예를 들어 implementer는 architecture/traceability를 쓰지 않는다 — 레이어 판단은 이미 designer가 끝낸 결정이고, 맞는지는 뒤에서 validator가 재검증하기 때문이다. 같은 규칙을 두 번 판단하게 하지 않고, 검증은 항상 한 곳(validator)에 모아 둔다.
11. 메모리 시스템
스킬이 처음부터 정해 둔 규칙을 재사용하는 장치라면, 메모리는 작업하다가 우연히 발견한 함정과 결정 이유를 다음 세션을 위해 남기는 장치다. 코드나 문서에서 바로 파생될 수 있는 내용은 굳이 옮겨 적지 않고, 다시 알아내기 어려운 맥락만 골라 기록한다는 점에서 스킬과 역할이 분명히 나뉜다.
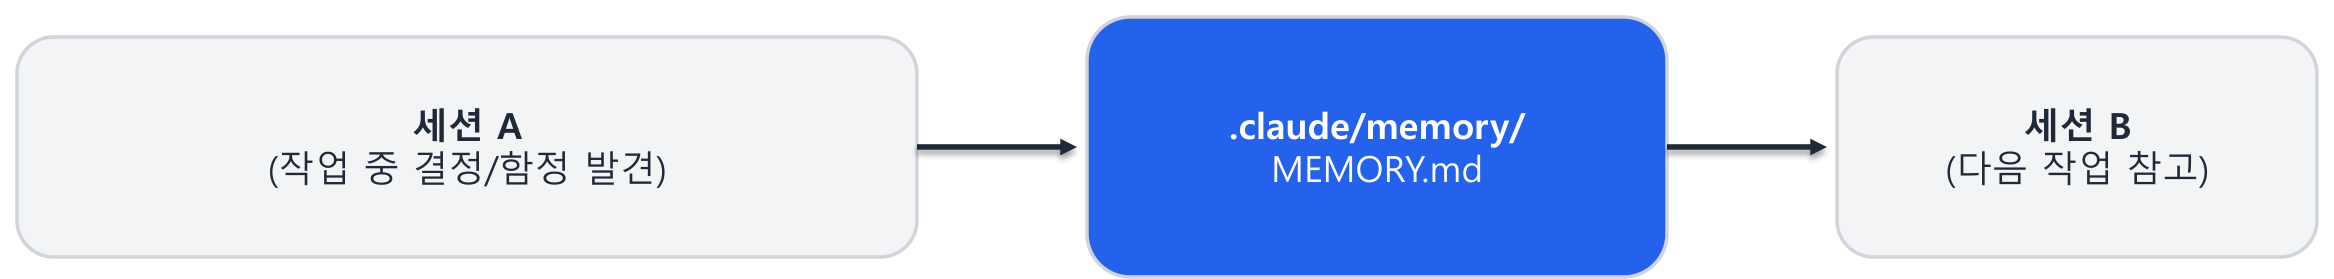
세션 A에서 작업 중 발견한 결정/함정을 .claude/memory/MEMORY.md에 기록하면, 세션 B가 이를 참고한다.
| 구분 | 대상 |
|---|---|
| 기록 대상 | 설계-구현 불일치 · 재발 가능한 함정 · 재구성 불가능한 결정 이유 |
| 기록 안 함 | 코드로 바로 파생되는 내용, 이미 문서화된 컨벤션 |
RAG-API의 실제 MEMORY.md에는 이런 항목들이 쌓여 있다.
- pptx page_label 타입 함정 — 서드파티 리더가 page_label에 int를 넣어
  str 스키마 계약을 깨고, 다중 KB 검색에서만 드러남 (US-47)
- JinaEmbedding single-task 함정 — query/passage task 자동분기가
  없어 embed.py에서 서브클래스로 강제 (US-50)
- config.settings ↔ pipeline import 함정 — settings.py가 chunk.py를
  import하면 순환 + Dagster code-server 부팅 probe 실패
- 의견만 물었을 때 바로 편집/커밋/push 금지
마지막 항목이 특히 흥미롭다. 어느 세션에서 사용자가 “index.md 기준으로 하는 게 맞지 않냐"고 의견을 물었을 뿐인데 AI가 바로 파일 3개를 고치고 커밋까지 해버렸다. 지적을 받고 나서도 같은 세션 안에서 두 번 더 재발했다 — 편집은 명시적 요청으로 했지만 별도 요청 없이 바로 커밋해버린 것, CI 실패를 “빨리 해결하려고” /spec-pr가 이미 설계해 둔 blocked 처리 경로를 기다리지 않고 임의로 워크플로우 정의 파일까지 고쳐 push해버린 것. 이 세 번의 재발이 그대로 MEMORY.md에 append되어 있다 — 지우거나 요약하지 않고, 왜 반복됐는지까지 그대로 남겨 다음 세션이 같은 실수를 반복하지 않게 한다.
12. 실전 사례 — US-53 검색 캐시
RAG-API에서 SpecRelay로 처리한 spec은 US-01 ~ US-55, 55건 이상이다. 그중 US-53 검색 응답 캐싱은 spec.md가 대화를 거치며 어떻게 다듬어지는지 잘 보여준다.
최초 지시는 단순했다 — “Redis 큐+캐시 겸용, 캐시 대상은 최종 응답 전체.” 그런데 analyst가 설계 검토 중 기존 아키텍처 문서의 “저장소 역할 분리”(Redis는 인제스트/삭제 큐 전용) 원칙과 정면으로 충돌한다는 점을 발견해 모순 보고로 멈췄다. 사용자가 “이미 확정된 결정이니 원칙을 의도적으로 깨는 예외로 진행하라"고 회신하면서, 캐시 설정(TTL/max_entries), 캐시 키 구성(질문 텍스트+KB+검색 옵션), 캐시 클리어 API 필요 여부까지 구체화됐다. 승인 직전 리뷰에서는 “정확 일치 외에 임베딩 유사도 기반 시맨틱 매칭도 범위에 포함해 달라"는 요청이 한 번 더 얹혔다.
최종 spec.md는 5개 세부 기능(F1~F5)과 2개 공통 완료 기준(C1, C2)으로 정리됐다.
- F1 Redis 캐시 설정값 (
enabled/ttl_seconds/max_entries/match_mode/semantic_threshold, 전부 기본값은 보수적으로 off) - F2 큐/캐시 Redis 키 네임스페이스 분리 — 기존 인제스트/삭제 큐와 충돌 금지
- F3 exact/semantic 매칭 정의 — query+kb_ids+검색 옵션 조합이 같아야 캐시 hit, semantic 모드에서는 임베딩 코사인 유사도로 판정
- F4 KB 문서 변경/삭제 시 캐시 자동 무효화
- F5 캐시 수동 클리어 API
- C2 아키텍처 문서(
docs/internal/architecture/README.md,data-schema.md)를 “Redis는 인제스트/삭제 큐 + 검색 결과 캐시 겸용"으로 갱신 — 문서 갱신 자체가 완료 기준에 포함돼 있어, 원칙을 깨는 예외를 만들면서도 문서와 코드가 다시 어긋나지 않도록 못박았다
이 spec.md 하나만 봐도 SpecRelay가 왜 “spec에는 소스코드 정보를 적지 않는다"는 원칙을 지키는지 알 수 있다 — F1~F5 어디에도 파일명이나 함수명이 없고, 오직 “무엇이 참이어야 완료인가"만 AC 단위로 명시돼 있다. 축출 정책(LRU/FIFO)이나 시맨틱 검색을 어디서 수행할지 같은 구현 디테일은 spec.md의 “오픈 이슈"로 넘겨져 design.md 단계에서 결정됐다.
이 외에도 US-11 Postgres 마이그레이션(메타데이터 저장소를 Redis에서 Postgres로 전환한 대규모 스키마 변경)이나 US-53~55로 이어지는 검색 캐시 개선처럼, 분석→설계→구현→분리까지 여러 spec에 걸쳐 반복 개선되는 사례들도 쌓여 있다. 실제 구성은 github.com/cnapcloud/rag-api의 .claude 디렉토리에서, 데모 환경은 cnapcloud.com/gitops에서 Rag Admin으로 확인할 수 있다.
13. 마치며
여기까지 SpecRelay의 4단계, 상태 관리, 안전장치, 지식 재사용 구조를 하나씩 살펴봤다. 이 모든 장치가 노리는 효과는 결국 네 가지로 수렴한다.
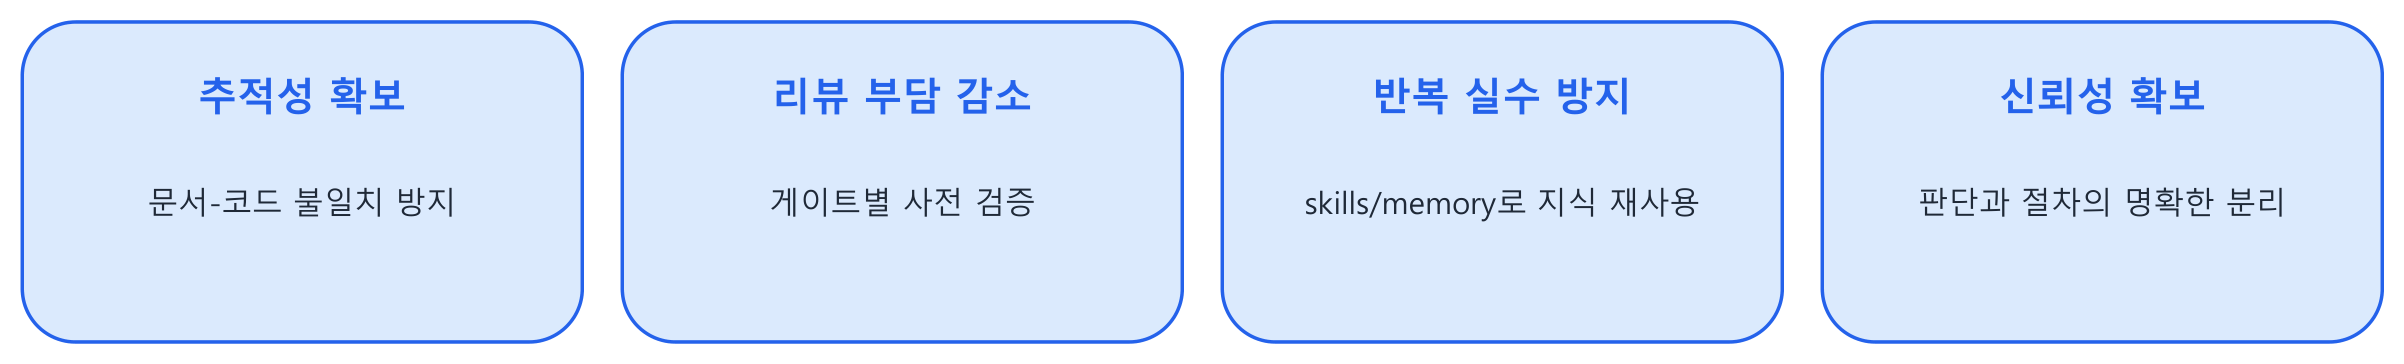
| 기대 효과 | 방법 |
|---|---|
| 추적성 확보 | 문서-코드 불일치 방지 (예: US-53 C2처럼 아키텍처 문서 갱신을 완료 기준에 직접 포함) |
| 리뷰 부담 감소 | 게이트별 사전 검증 (architecture 재검증, 전체 회귀 검증) |
| 반복 실수 방지 | skills/memory로 지식 재사용 (같은 pitfall을 MEMORY.md에서 재발까지 추적) |
| 신뢰성 확보 | 판단(agent)과 절차(command)의 명확한 분리 |
SpecRelay는 완벽한 설계도라기보다, RAG-API를 실제로 개발하며 발견한 문제(모순 보고 없이 진행돼버린 설계, 승인 없이 넘어간 커밋, 이유가 사라진 결정)에 대응해 하나씩 게이트를 추가해 온 결과물에 가깝다. feedback_confirm_before_edit.md에 세 번의 재발이 그대로 남아 있는 것처럼, 이 워크플로우 자체도 계속 갱신되는 중이다.
부록 — SpecRelay vs Spec Kit 토큰 비용 실측
1절에서 언급한 비용 비교의 실측 근거다. 동일한 요구사항(사용자 목록 조회 + 특정 사용자의 KB 멤버십 조회 API)을 rag-ent-api에서 SpecRelay(이번 방식)와 Spec Kit 표준 워크플로우(170턴)로 각각 실행해 세션 로그의 message.usage를 집계한 값이다.
| 지표 | SpecRelay | SpecKit | 배율 |
|---|---|---|---|
| 턴 수 | 64 | 170 | 2.66x |
| 신규 입력 | 387 | 337 | 0.87x |
| 캐시 쓰기 | 745,982 | 273,647 | 0.37x |
| 캐시 읽기 | 8,631,380 | 33,930,146 | 3.93x |
| 출력 | 67,491 | 123,139 | 1.82x |
| 가중 토큰 합계* | 2,133,458 | 4,351,105 | 2.04x |
| 추정 비용** | ≈$6.40 | ≈$13.05 | 2.04x |
* 입력 1x · 출력 5x · 캐시 쓰기 1.25x · 캐시 읽기 0.1x 가중치로 위 네 지표를 환산해 합산한 값이다. ** Claude Sonnet 계열 공개 단가(입력 $3/M · 출력 $15/M · 캐시 쓰기 $3.75/M · 캐시 읽기 $0.30/M, 1M=100만 토큰)를 위 네 지표에 그대로 곱해 합산한 근사치다. 실제 청구액과는 다를 수 있다.
speckit은 경량화 없이 표준 7단계 전체를 실행했고, 스킬·요구사항은 SpecRelay와 동일하게 맞췄다. 다만 clarify 확인사항은 사용자 응답 대신 LLM이 가정해 답하도록 처리했다. 턴 수 격차는 이 단계 수 차이(4단계 vs 7단계)에서 비롯된 것으로 보인다. 그 외 각 항목이 왜 이런 비율로 갈렸는지는 구조적으로 더 분석해보아야 하는 부분이라, 이 글의 범위를 벗어나 다루지 않는다.
단일 기능 1회 실행 기준 관측치이며, 반복 실행이나 다른 기능에서는 수치가 달라질 수 있다.
참고 자료
- Vibe Coding Trends 2026: Adoption, Productivity, and Code Quality Data — Keyhole Software
- AI Technical Debt: How Vibe Coding Increases TCO — Baytech Consulting
- AI Code Quality Crisis 2026: Engineering Leader Guide — ofashandfire
- Vibe Coding and Technical Debt: The Hidden Costs of AI-Generated Code — Codepanion
- The Vibe Coding Crisis: How AI-Generated Technical Debt Is Costing Companies Millions — Kyros
- GitHub Spec Kit (공식 저장소)
- GitHub Spec Kit: A Guide to Spec-Driven AI Development — IntuitionLabs
- Comprehensive Guide to Spec-Driven Development: Kiro, GitHub Spec Kit, and BMAD-METHOD — Medium
- 6 Best Spec-Driven Development Tools for AI Coding in 2026 — Augment Code
- Spec-Driven Development (SDD): The Definitive 2026 Guide — TheBCMS